MegaMem은 방대한 기업 문서에서 답의 근거를 어떻게 찾나
MegaMem의 원문과 메모 이중 인덱스, 질문 재작성과 확장, 원문 복원, RRF, 재정렬, 답변과 출처 표시를 하나의 예시로 추적하고 논문 점수와 CDL 리더보드의 관계를 구분합니다.
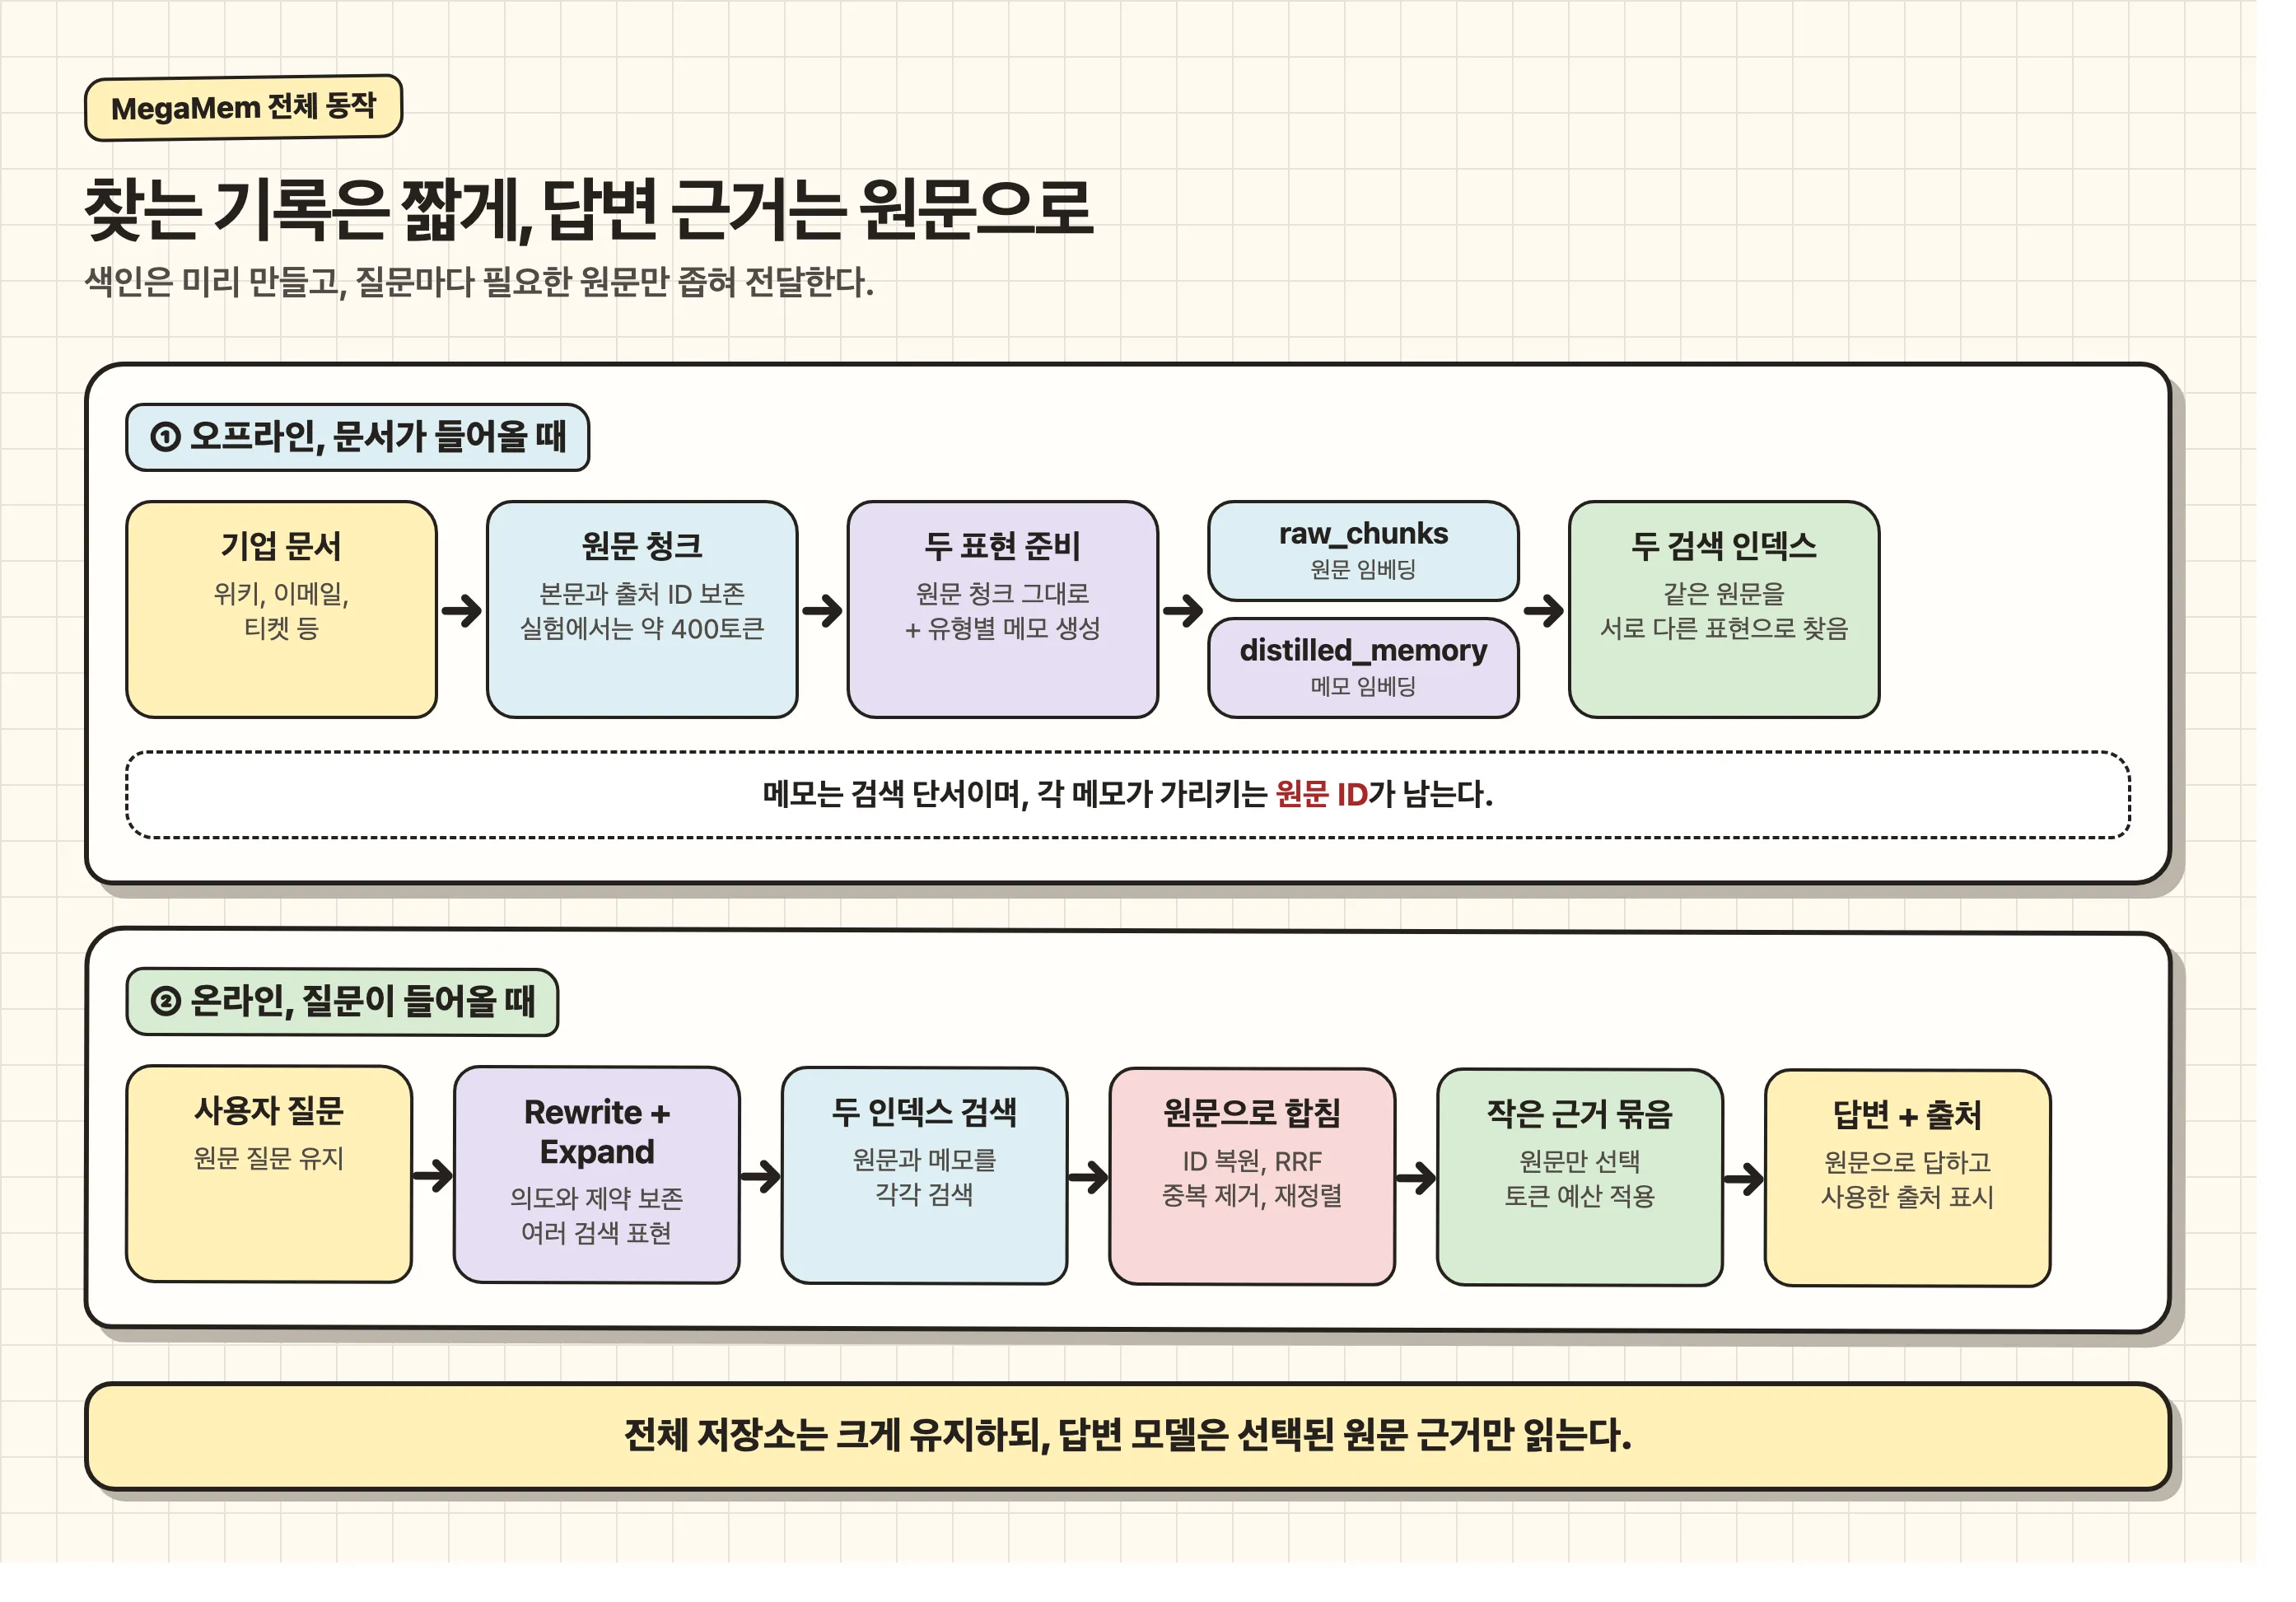
사내 검색 에이전트가 “P1 장애가 나면 고객에게 언제 알려야 하나요?”라는 질문을 받습니다. 답은 위키 정책에 있지만, 검색 결과에는 예전 정책, 장애 티켓, 채팅 기록이 함께 섞일 수 있습니다. 관련 문서를 넓게 찾으면서도 답변에는 정확한 원문 근거만 넣어야 합니다.
MegaMem은 이 문제를 위해 원문 청크와 짧게 추출한 메모를 각각 검색하고, 메모에서 찾은 내용도 원문으로 되돌린 뒤 답변하는 방식입니다. 위키 전용 시스템은 아닙니다. 논문은 위키, 이메일, 티켓 등을 포함한 기업 문서 모음에서 검색 가능한 전체 자료와 답변 모델이 한 번에 읽는 근거를 분리합니다. MegaMem 논문, EnterpriseRAG-Bench
1. 거대한 저장소와 작은 답변 문맥
논문은 검색 가능한 전체 문서를 persistent context, 한 질문에 골라 답변 모델에 넣는 원문 묶음을 evidence context로 구분합니다. 후자에는 토큰 예산이 있습니다. 문서를 더 많이 저장하더라도 매 질문마다 전부 읽지 않고, 답에 필요한 근거를 찾아 전달하는 것이 설계 목표입니다. 논문 §2
원문만 임베딩하면 질문과 문서의 표현이 다를 때 필요한 청크를 놓칠 수 있습니다. 반대로 짧은 요약만 답변 모델에 주면 날짜, 예외, 충돌처럼 답을 결정하는 세부 조건이 빠질 수 있습니다. MegaMem은 짧은 기록을 찾는 데 쓰고, 답은 원문으로 만든다는 규칙으로 두 문제를 연결합니다. 논문 §1, §3
2. 오프라인 색인: 원문과 메모를 함께 저장
먼저 문서를 제목과 문단 경계에 따라 원문 청크로 나눕니다. 실험의 raw_chunks 컬렉션에는 대략 400 cl100k_base 토큰 길이의 청크가 들어갑니다. 각 청크는 본문과 출처 정보를 보존합니다. 논문 §3.1, 부록 B
그다음 LLM이 청크에서 검색에 도움이 되는 짧은 메모를 최대 세 개 추출합니다. 메모 유형은 fact, procedure, definition, requirement, decision의 다섯 가지입니다. 쓸 만한 정보가 없는 청크는 메모를 만들지 않아도 됩니다. 각 메모에는 유형, 검색용 키, 짧은 진술, 원문 청크 ID가 들어갑니다. 논문 §3.1
다음은 구조를 이해하기 위한 가상 예시입니다. 논문 데이터셋의 실제 문서가 아닙니다.
원문 청크 POL-101#2
“P1 장애가 발생하면 고객에게 30분 이내 공지한다.”

추출 메모
type: requirement
search_key: P1 장애 고객 공지 시한
value: 고객에게 30분 이내 공지
source_chunk_id: POL-101#2
원문 청크는 raw_chunks, 메모는 distilled_memory에 각각 임베딩합니다. 논문 실험은 두 컬렉션 모두 text-embedding-3-small의 1,536차원 벡터를 사용하고, ChromaDB의 HNSW 인덱스에서 코사인 거리로 검색했습니다. 메모의 벡터가 원문 벡터를 대체하는 것은 아닙니다. 두 검색 경로가 동일한 원문 ID로 만납니다. 논문 부록 B
메모 추출기에도 두 설정이 있습니다. MiniExtractor는 원자적 메모를 만들고, FullExtractor는 상위 수준의 검색용 추상화도 추가합니다. 원자적 메모 추출에는 gpt-5.4-mini, 상위 추상화에는 gpt-5.4를 사용했습니다. 이 차이는 뒤의 성능 수치를 읽을 때 중요합니다. 논문 §3.1, 부록 G
3. 질문 재작성과 확장: 같은 정보 요구를 여러 경로로 찾기
질문이 들어오면 원문 질문을 버리지 않습니다. gpt-5.4가 질문의 핵심 의도와 이름, 시간 같은 제약을 보존하면서 canonical rewrite와 용어가 다른 확장 질문을 만듭니다. 논문에 실린 프롬프트는 답, 새 개체, 날짜를 지어내지 말고 JSON 목록으로 반환하도록 요구합니다. 안전하게 바꿀 수 없거나 변환 호출이 실패하면 원문 질문만 사용합니다. 논문은 확장 질문의 고정 개수를 명시하지 않습니다. 논문 §3.2, 부록 G, J, 논문 소스의 프롬프트
| 경로 | 가상 예시 질문 | 역할 |
|---|---|---|
| 원문 | P1 장애가 나면 고객에게 언제 알려야 하나요? | 사용자의 표현과 제약 보존 |
| canonical rewrite | P1 장애 고객 공지 시한 | 검색에 필요한 핵심어를 분명히 함 |
| 용어 확장 | P1 고객 통지 시간, P1 incident customer notification deadline | 다른 문서 표현에 닿을 기회 추가 |
위 변형 문장은 설명용으로 만든 예시입니다. P1이라는 조건을 유지하고, 정책의 정답인 “30분”은 검색어에 미리 넣지 않았습니다. 실제 논문에서는 원문, 재작성, 확장 경로가 각각 원문 인덱스와 메모 인덱스를 모두 검색합니다. 즉 질문 경로가 세 개라면 검색은 최대 여섯 갈래로 퍼집니다. 갈래 수는 실제 생성된 확장 질문 수에 따라 달라집니다. 논문 §3.2
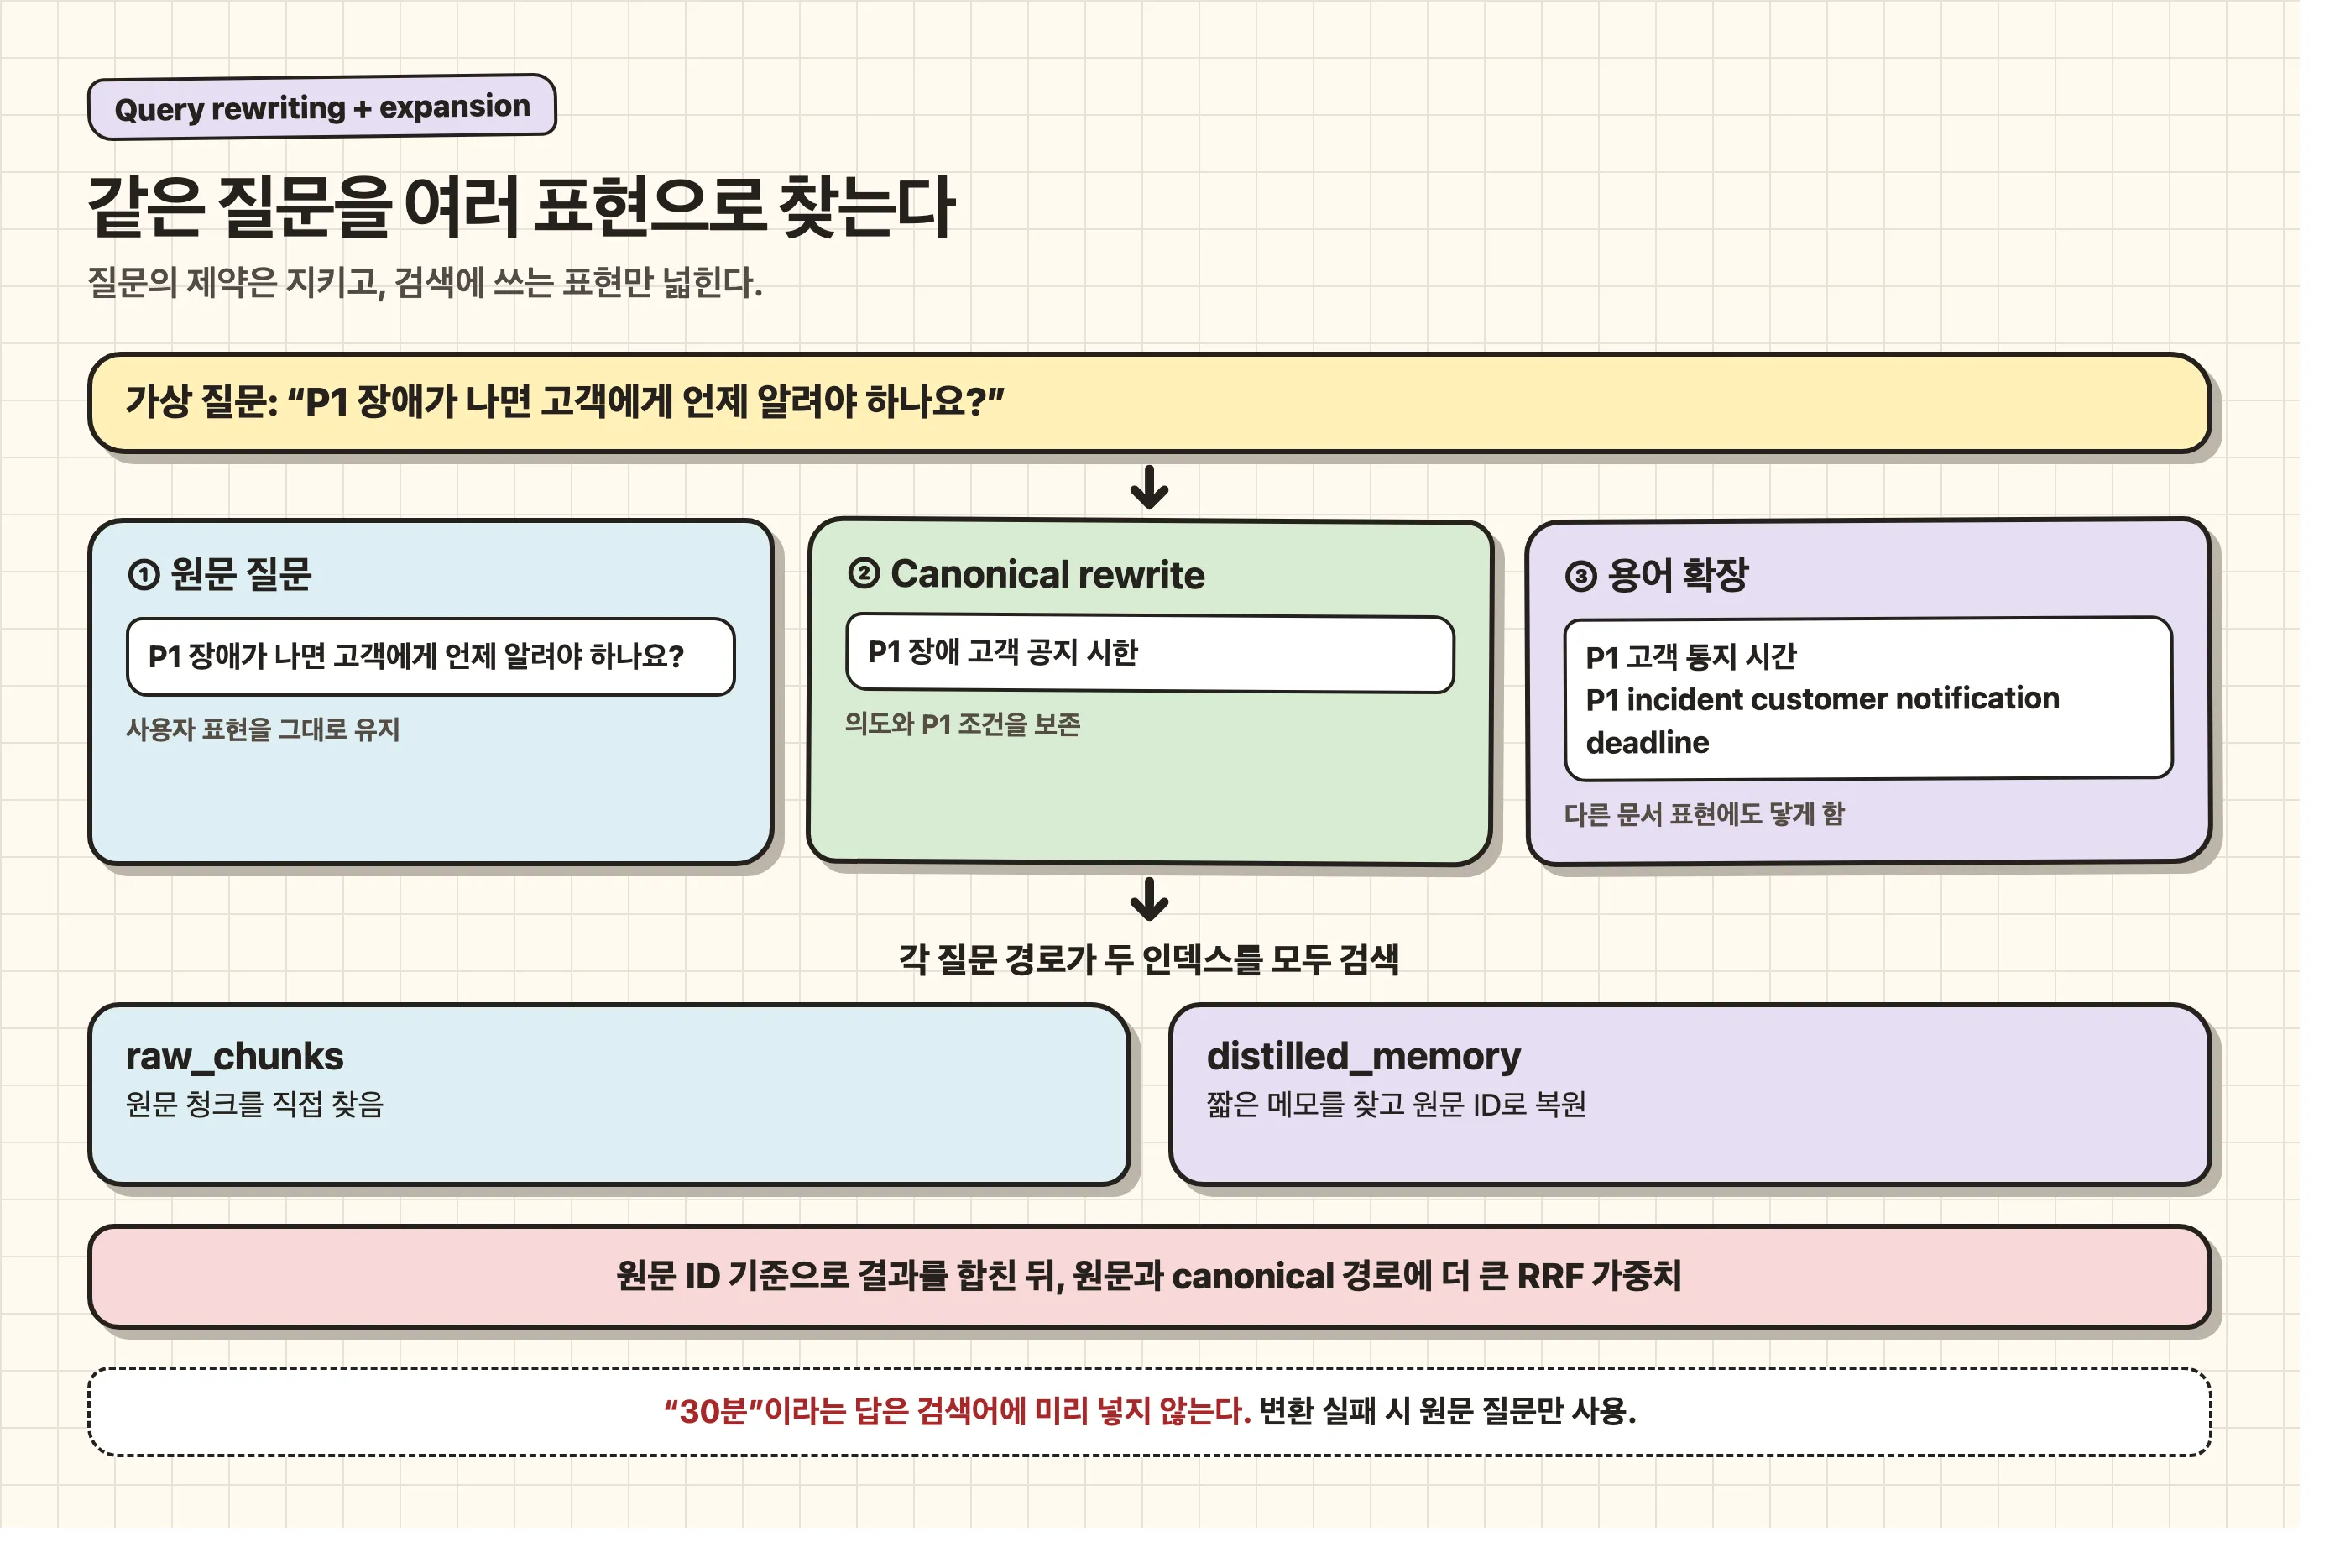
이 단계는 특히 사내 용어가 제각각인 문서에서 도움이 됩니다. 사용자는 “알려야 하나”라고 묻고 정책은 “고객 공지”, 티켓은 “notification deadline”이라고 쓸 수 있습니다. 다만 질문을 넓히면 답이 없는 문제에도 그럴듯한 문서가 걸릴 수 있습니다. 논문의 진단 실험에서는 기본 검색이 놓친 대상 33개 중 13개를 확장으로 찾았지만, 무조건 확장했을 때 답이 없는 질문의 정답률은 100%에서 68.8%로 떨어졌습니다. 논문의 selective oracle은 답변 가능성을 이미 아는 이상적 실험 조건이며, 배포된 판별기로 해석하면 안 됩니다. 논문 §5.3, 부록 F
4. 메모 검색 결과를 원문 근거로 되돌리기
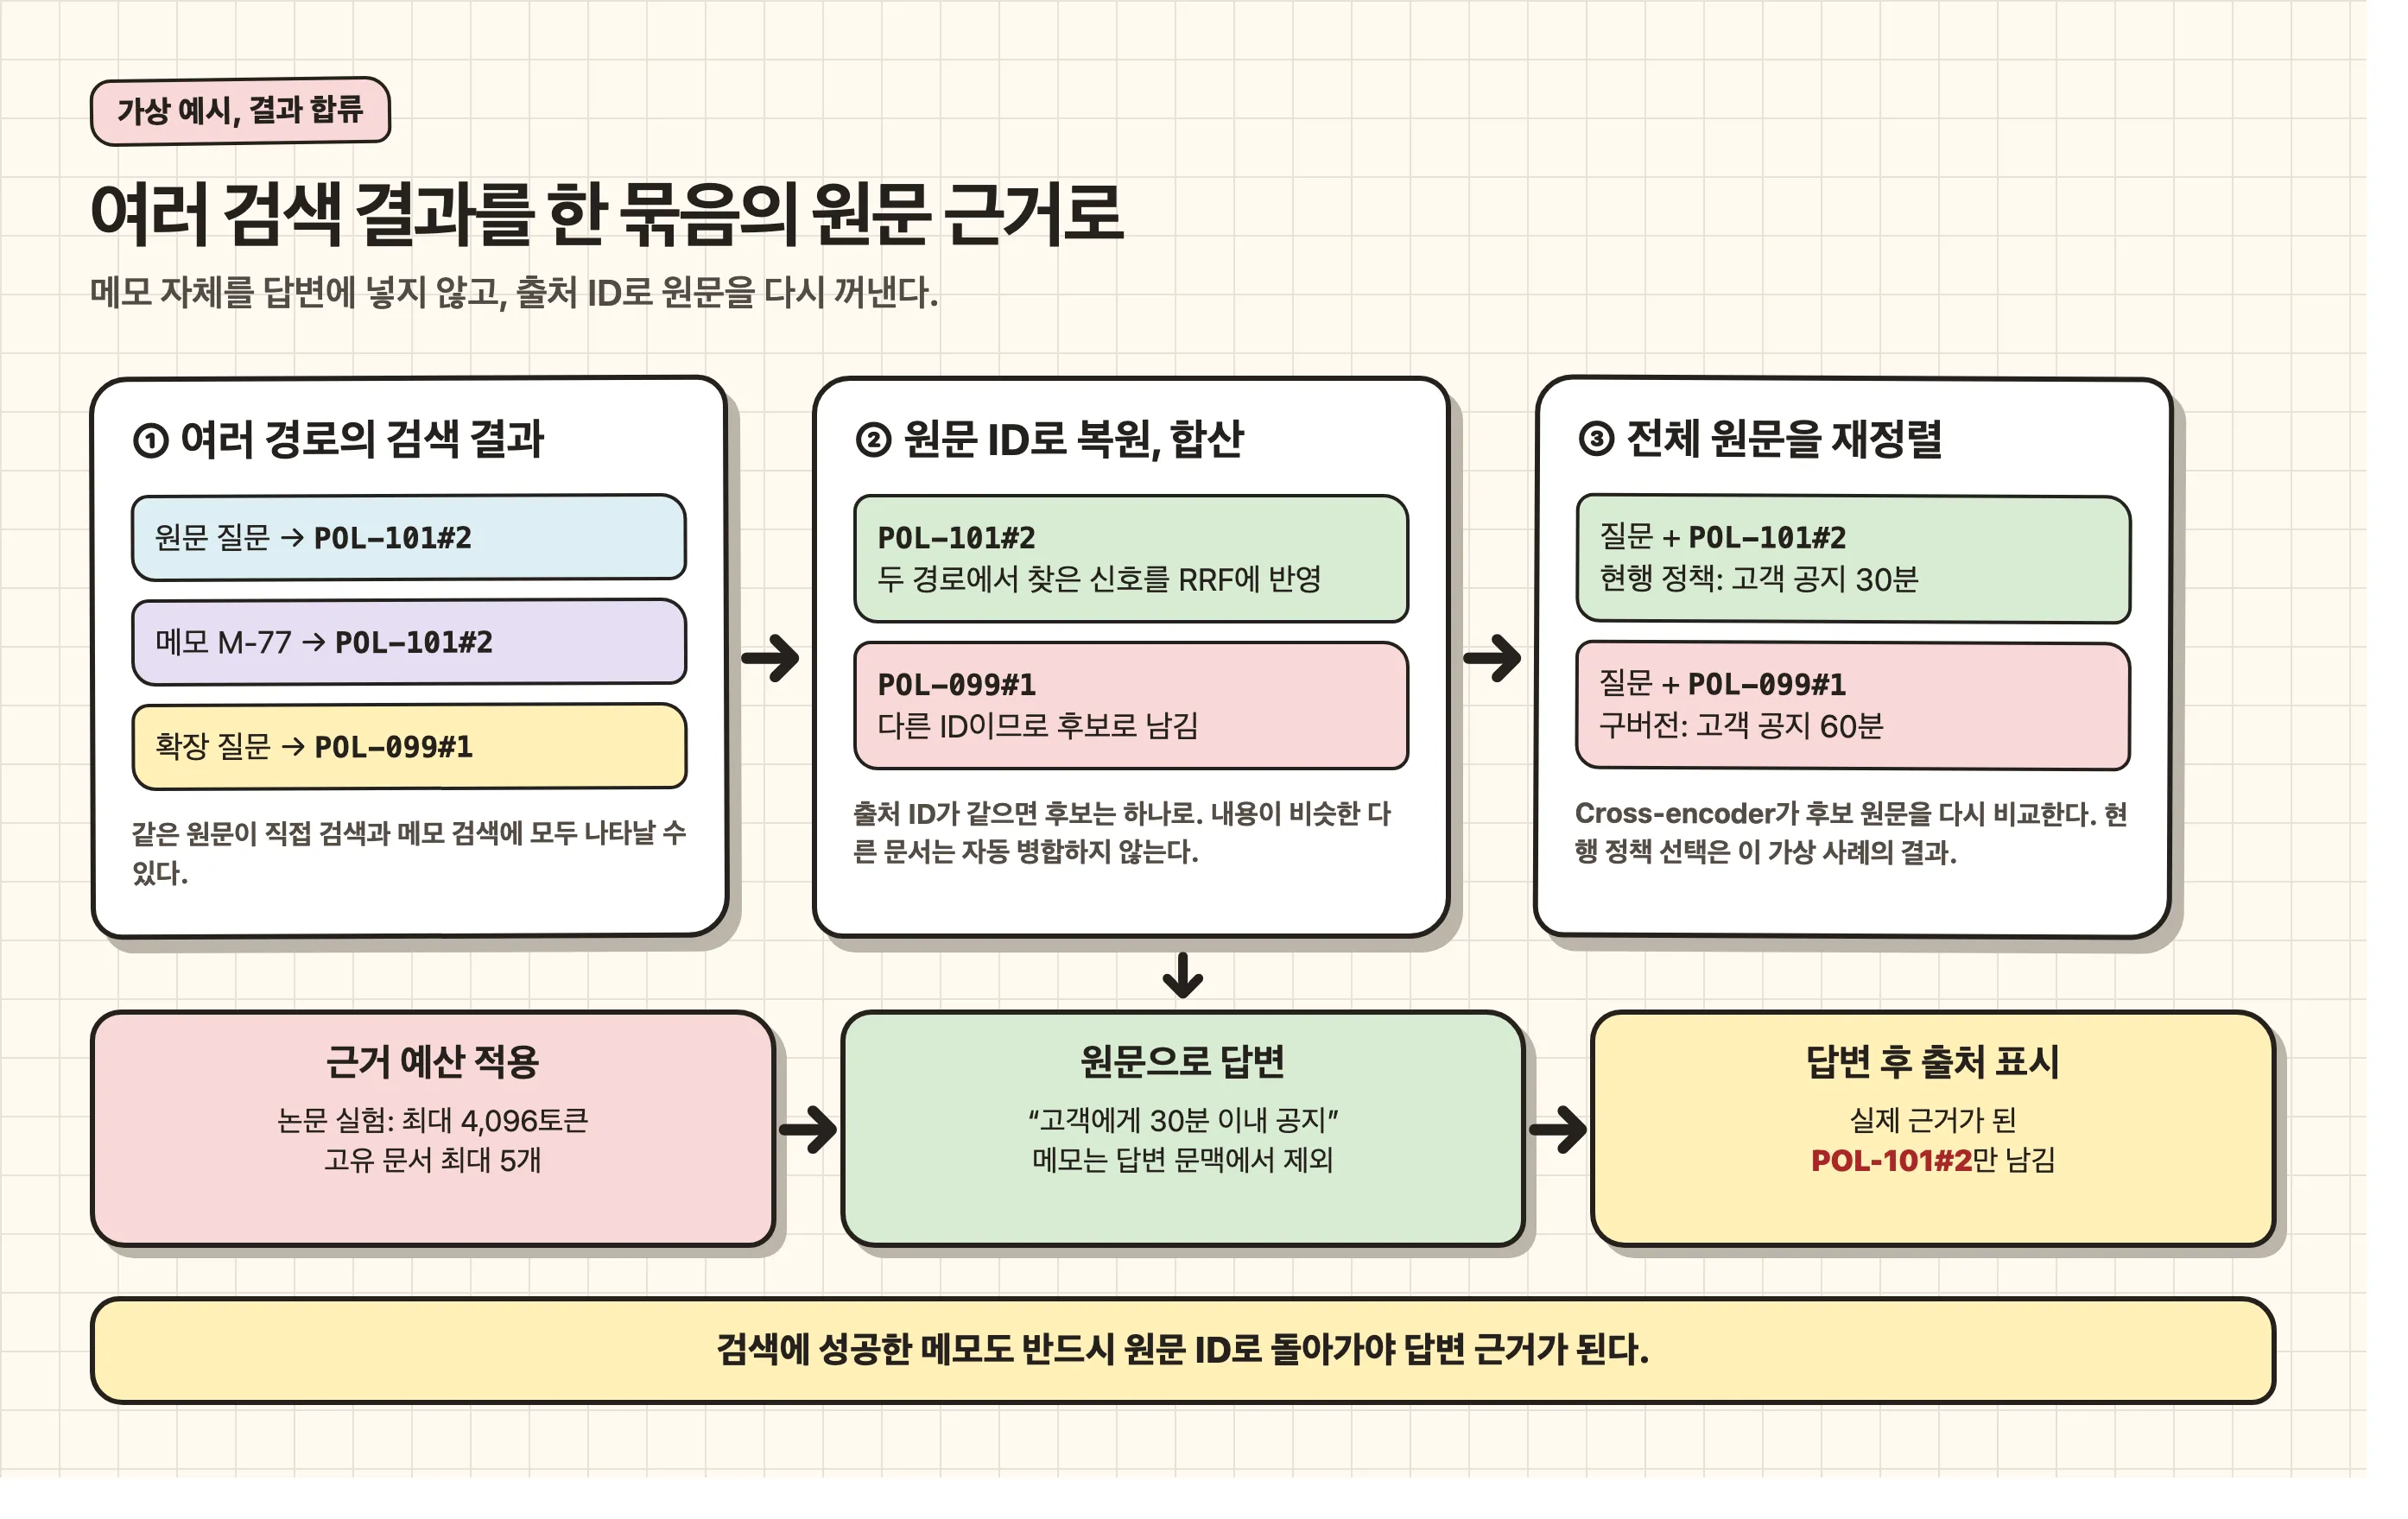
원문 인덱스의 결과는 바로 원문 청크를 가리킵니다. 메모 인덱스의 결과는 메모에 저장된 source_chunk_id를 따라 원문 청크로 변환합니다. 메모가 질문을 잘 잡아냈더라도 그 짧은 문장만 답변 모델에 보내지 않습니다. 논문 §3.2
원문 질문 → raw_chunks 검색             → POL-101#2
확장 질문 → distilled_memory 검색 → 메모 M-77 → POL-101#2
                                               ↓
                                  같은 원문 근거 한 개로 합침
같은 청크가 여러 질문 경로와 두 인덱스에서 발견될 수 있습니다. MegaMem은 먼저 결과를 원문 ID 기준으로 맞춘 뒤, 경로별 순위를 가중 RRF로 합칩니다. 논문은 γ=60을 사용하고 원문 질문과 canonical rewrite 경로에 보조 확장 경로보다 높은 가중치를 줍니다. 경로별 정확한 가중치 값은 명시하지 않습니다. 내용이 비슷해도 원문 ID가 다른 문서까지 의미만으로 합친다는 뜻은 아닙니다. 논문 §3.2
합쳐진 후보는 Cross-encoder가 질문과 원문 청크 전체를 다시 읽고 순위를 매깁니다. 이후 동일한 출처 ID의 중복을 제거하고, 상위 원문만 토큰 예산 안에 담습니다. 논문 실험 설정은 답변 근거 최대 4,096토큰, 재정렬 후 최대 다섯 개의 고유 문서였습니다. 이 수치는 해당 실험의 설정이지 모든 위키에 그대로 적용할 기본값은 아닙니다. 논문 §3.2, 부록 G
5. 답변 생성과 출처 표시는 별개 단계
답변 모델은 선택된 상세 원문 근거만 받습니다. 짧은 메모와 탈락한 검색 결과는 답변 입력에 포함되지 않습니다. 답변을 만든 뒤 별도 attribution 단계가 이미 읽은 근거 중 실제 답을 지지하는 출처를 고릅니다. attribution은 인용 목록을 줄일 수 있지만 이미 생성된 답변 내용을 수정하지는 않습니다. 논문 §3.3
논문의 구성요소 실험에서 attribution을 제거해도 답변 품질 점수는 같았고, 보고한 문서는 질문당 평균 2.31개에서 5.00개로 늘었습니다. 이 단계의 역할은 새 답을 찾는 것보다 출처 표시를 좁히는 것에 가깝습니다. 논문 §5.3
호출 실패 시의 처리도 정해져 있습니다. 재시도 후에도 메모 추출이 실패하면 해당 청크에는 메모를 만들지 않고, 질문 변환이 실패하면 원문 질문을 사용합니다. attribution이 실패하면 출처 목록은 비우며, 답변 생성까지 실패하면 정해 둔 답변 보류 문구를 반환합니다. 이 경로는 “답이 없다”는 판단과 시스템 호출 실패를 평가에서 구분해야 한다는 점도 보여줍니다. 논문 부록 G
6. 가상 기업 문서 질문을 끝까지 따라가기
지금까지의 POL-101#2를 다른 자료와 함께 놓아 보겠습니다. POL-101#2에는 현재 고객 공지 시한 30분이 있고, 오래된 위키 청크 POL-099#1에는 60분이 적혀 있습니다. 티켓 INC-301#4는 예전 정책이 사용된 장애를 기록합니다. 세 자료와 아래 검색 순위는 모두 흐름을 설명하기 위한 가상 값입니다.
| 단계 | 예시에서 일어난 일 |
|---|---|
| 질문 변환 | 원문 질문을 남기고 P1 장애 고객 공지 시한 등으로 검색 경로를 넓힘 |
| 두 인덱스 검색 | 현행 정책의 원문 청크와 그 청크에서 추출한 메모를 찾음 |
| 출처 복원 | 메모의 출처 ID를 POL-101#2로 변환 |
| 결과 선택 | POL-101#2, POL-099#1, INC-301#4를 비교하고 현재 정책을 근거로 고름 |
| 답변과 인용 | “고객에게 30분 이내 공지합니다”라고 답하고 POL-101#2를 표시 |
이 예시는 현재 정책을 찾는 데 필요한 정보가 색인과 검색 결과에 보존되어 있다고 가정합니다. MegaMem 논문은 원문에 있는 출처 정보를 유지하지만, 특정 Confluence 설치의 권한이나 페이지 상태를 자동 판별하는 규칙을 제시하지는 않습니다.
7. 성능 숫자와 리더보드의 관계
MegaMem을 발표한 연구팀은 CDL(Causal Dynamics Lab)입니다. CDL의 공식 연구 목록에도 MegaMem이 있습니다. 2026년 10월 14일 기준 EnterpriseRAG-Bench 리더보드의 1위 항목은 CDL, Overall 90.91점입니다. 리더보드는 제출 시스템의 이름을 MegaMem으로 표시하지 않고, 공개 자료만으로는 90.91점을 낸 구성이 논문의 MegaMem과 동일한지 확인되지 않습니다.
논문의 MegaMem 점수는 82.26점입니다. 이 수치는 전체 500개 질문 중 개발에 사용한 100개를 제외한 400개 검증 질문, 10M 토큰 규모, FullExtractor 구성에서 얻었습니다. 따라서 CDL의 공식 리더보드 점수나 전체 대규모 문서에서의 성능으로 읽으면 안 됩니다. 규모 실험은 MiniExtractor를 사용했고 250M 토큰에서 Overall 58.02점을 보고했습니다. 서로 다른 실험의 숫자를 같은 순위표에 꽂지 않는 이유입니다. 논문 실험 프로토콜
구성요소 제거 실험에서는 두 인덱스나 메모 추출을 뺐을 때 점수 하락이 query expansion이나 재정렬을 뺐을 때보다 컸습니다. 이것은 원문과 메모를 병렬 검색하는 구조가 성능의 중심이라는 논문 내 비교입니다. 한편 문서가 커질수록 필요한 근거를 찾는 일이 어려워져, 검색된 근거를 쓴 점수는 내려가지만 정답 근거를 직접 준 경우의 답변 정확도는 상대적으로 안정적이었습니다. 논문 §5.3, 부록 C
8. 비용과 이 방법의 위치
색인은 질문마다 하는 작업이 아니라 문서를 미리 처리하는 작업입니다. 논문의 측정에서는 60M 토큰 색인에 9.3시간, 250M 토큰에는 약 5.6일이 걸렸습니다. 반면 60M~100M 토큰 설정의 온라인 검색은 0.30~1.10초, 답변까지는 2.5~3.3초였습니다. 모두 논문의 장비와 실험 설정에서 측정한 값입니다. 논문 비용 표
최종 MegaMem은 개체와 관계를 탐색하는 GraphRAG 구조를 사용하지 않습니다. 연구 과정에서 계층과 관계 기반 메모를 시험했지만 최종 설계에는 원문 인덱스와 메모 인덱스만 남겼습니다. 짧은 메모는 검색 단서이고, 원문 ID로 돌아간 청크가 답변 근거라는 관계를 끝까지 지키는 방식입니다. 논문 §3, 부록 D