GraphRAG는 그래프에서 어떤 근거를 찾아 답하는가
TAG와 GNN부터 그래프 인덱싱, 검색기, 반복 검색, 근거 선택과 답변 생성까지 수식 없이 설명합니다.
GraphRAG는 그래프에서 어떤 근거를 찾아 답하는가 슬라이드
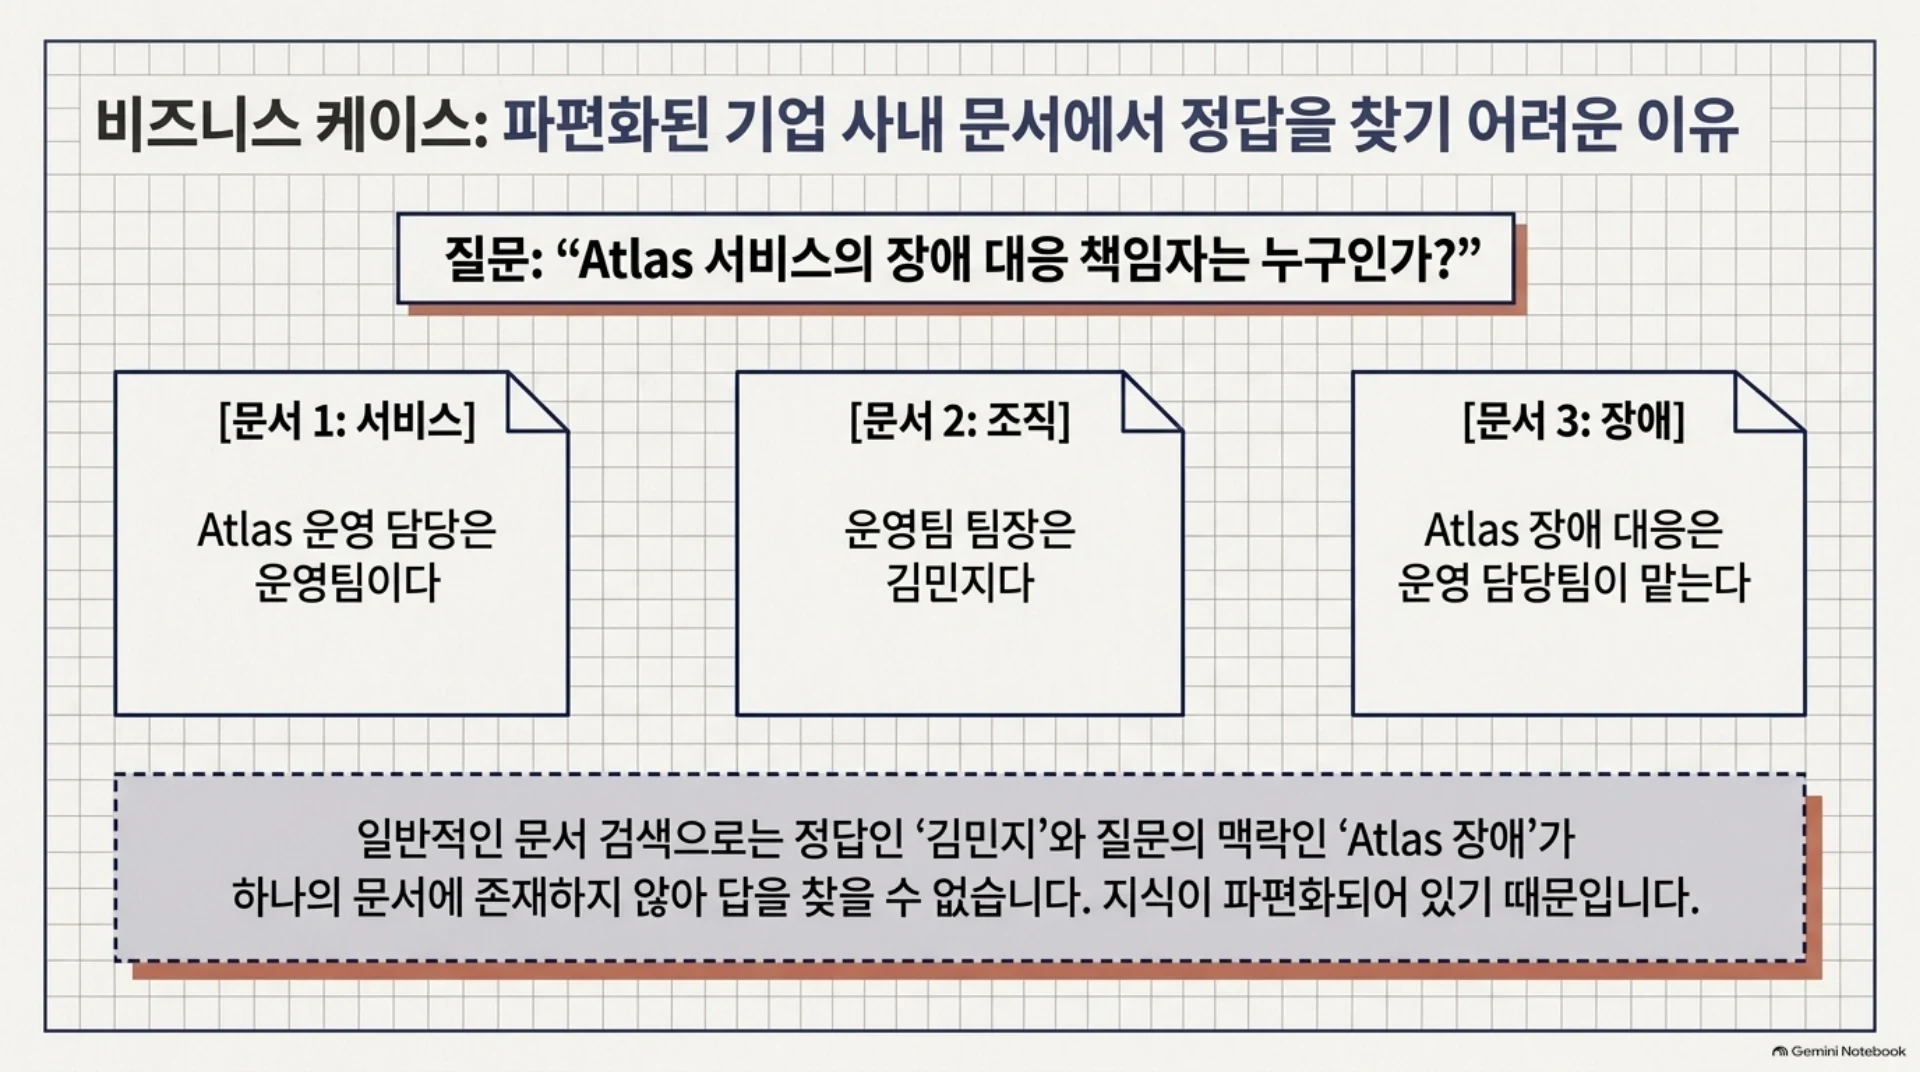
“Atlas 서비스의 장애 대응 책임자는 누구인가?”라는 질문에 답하려면 Wiki의 한 문장만 찾는 것으로 부족할 수 있습니다. 서비스 문서는 담당 팀을 적고, 조직 문서는 그 팀의 책임자를 적을 수 있습니다. 두 사실을 이어야 비로소 사람 이름이 나옵니다.
GraphRAG는 이런 개체 사이의 연결을 검색 근거로 다룹니다. 문서를 그래프로 표현하고, 질문에 필요한 연결 부분을 골라 LLM에 전달합니다. 이 글에서는 그래프를 어떻게 만들고, 무엇을 검색하며, 검색 결과가 어떻게 답으로 바뀌는지 수식 없이 따라갑니다. Atlas, 운영팀, 김민지는 흐름을 설명하기 위한 가상의 Wiki 데이터입니다.
1. GraphRAG가 필요한 질문
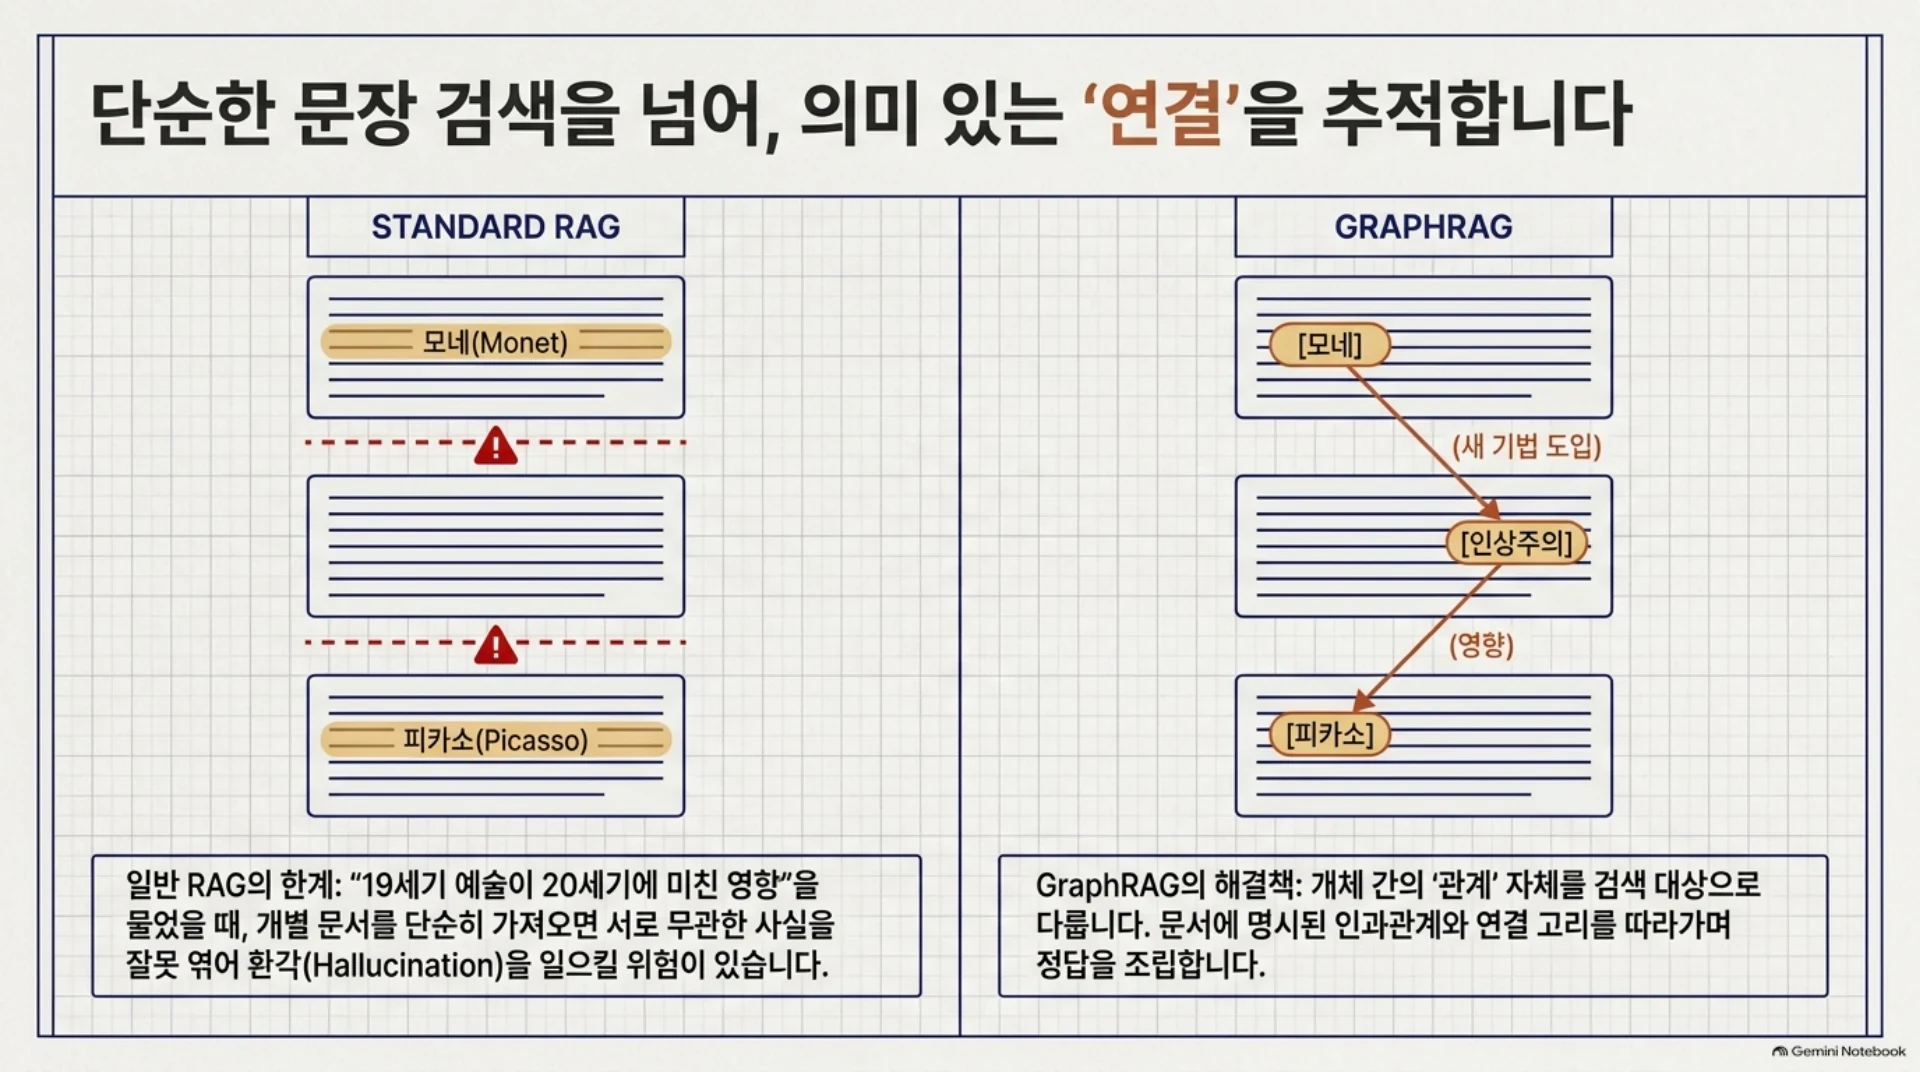
“19세기 예술 운동이 20세기 현대미술에 어떤 영향을 줬나?”라는 질문을 생각해 보겠습니다. 질문만 받은 LLM은 색과 형태의 실험 같은 일반적인 설명을 만들 수 있습니다. 일반 RAG는 인상주의, 모네, 피카소에 관한 문장을 검색해 건네지만, 서로 다른 문장에 있는 사실을 잘못 연결할 수도 있습니다. GraphRAG는 모네 → 새 기법 도입, 인상주의 기법 → 후대 운동에 영향처럼 관계를 별도의 검색 대상으로 다룹니다.
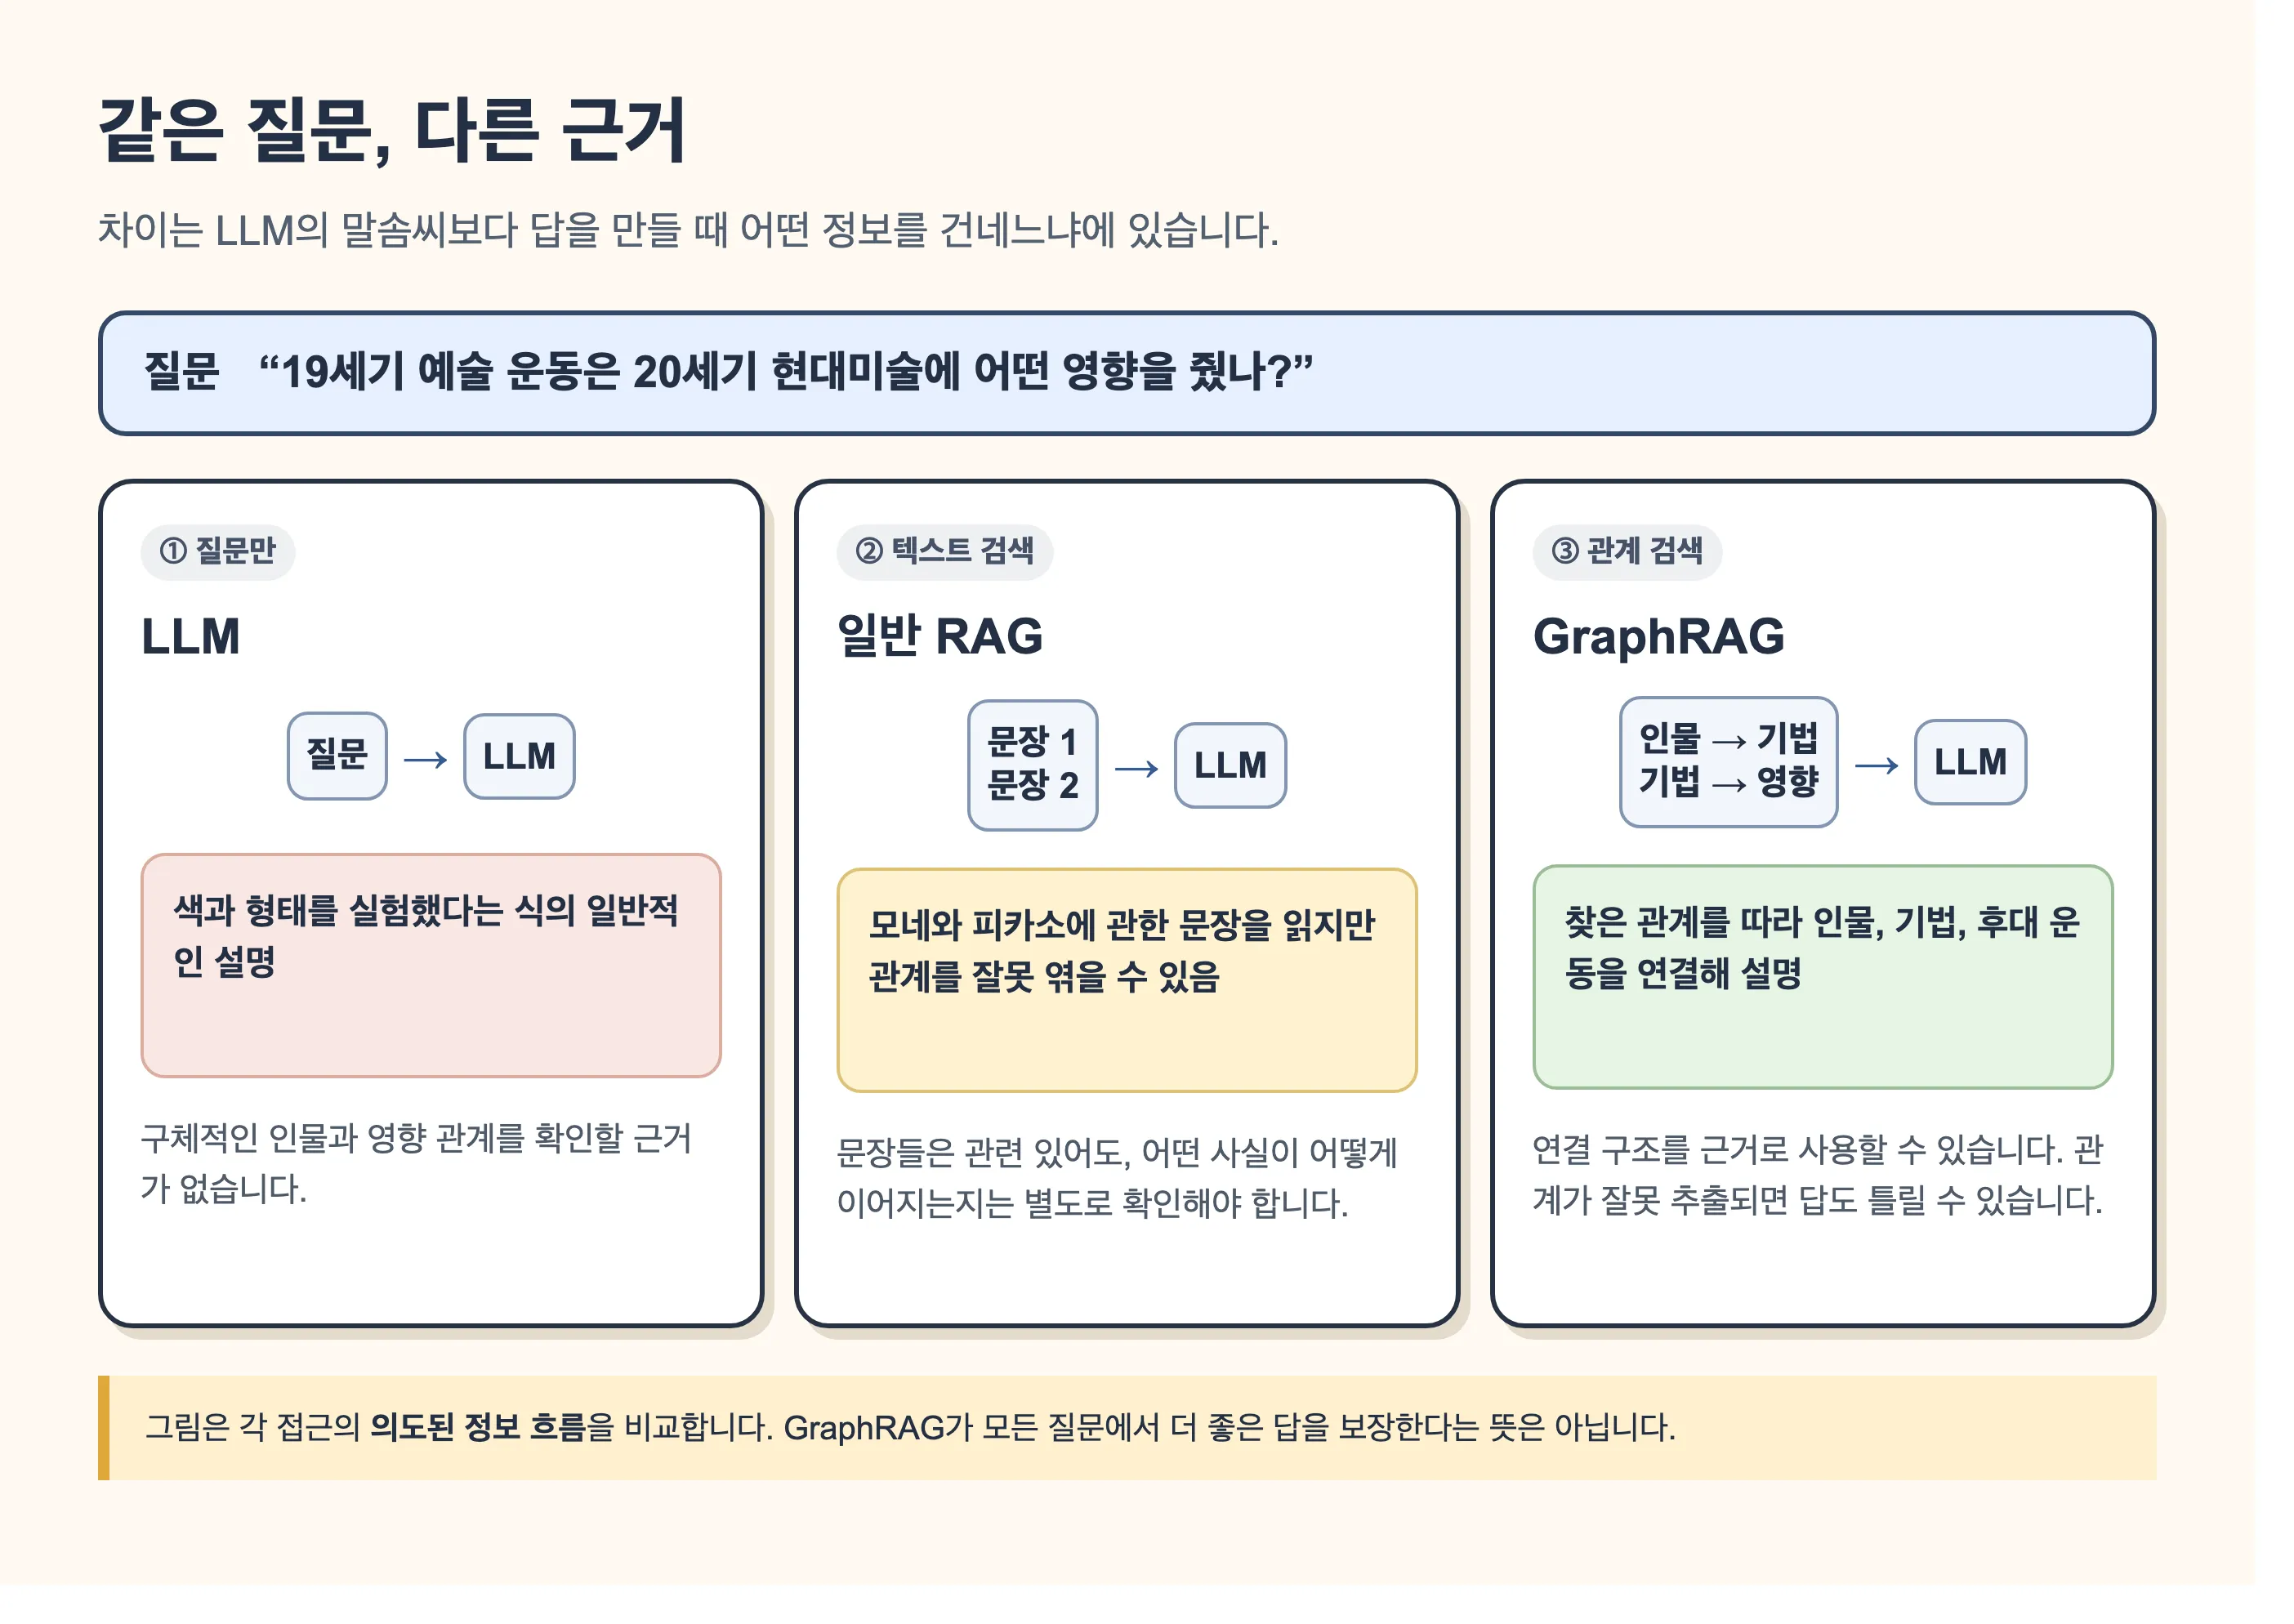
이 그림은 세 방법의 입력 형태를 비교합니다. 그래프가 있다는 사실만으로 정답이 보장되지는 않습니다. 잘못 추출한 관계나 질문과 무관한 관계를 선택하면 GraphRAG도 잘못 답합니다. 이 방식이 특히 필요한 때는 여러 문서의 개체와 관계를 이어야 하는 질문입니다.
2. 그래프의 기본 단위: TAG와 Knowledge Graph
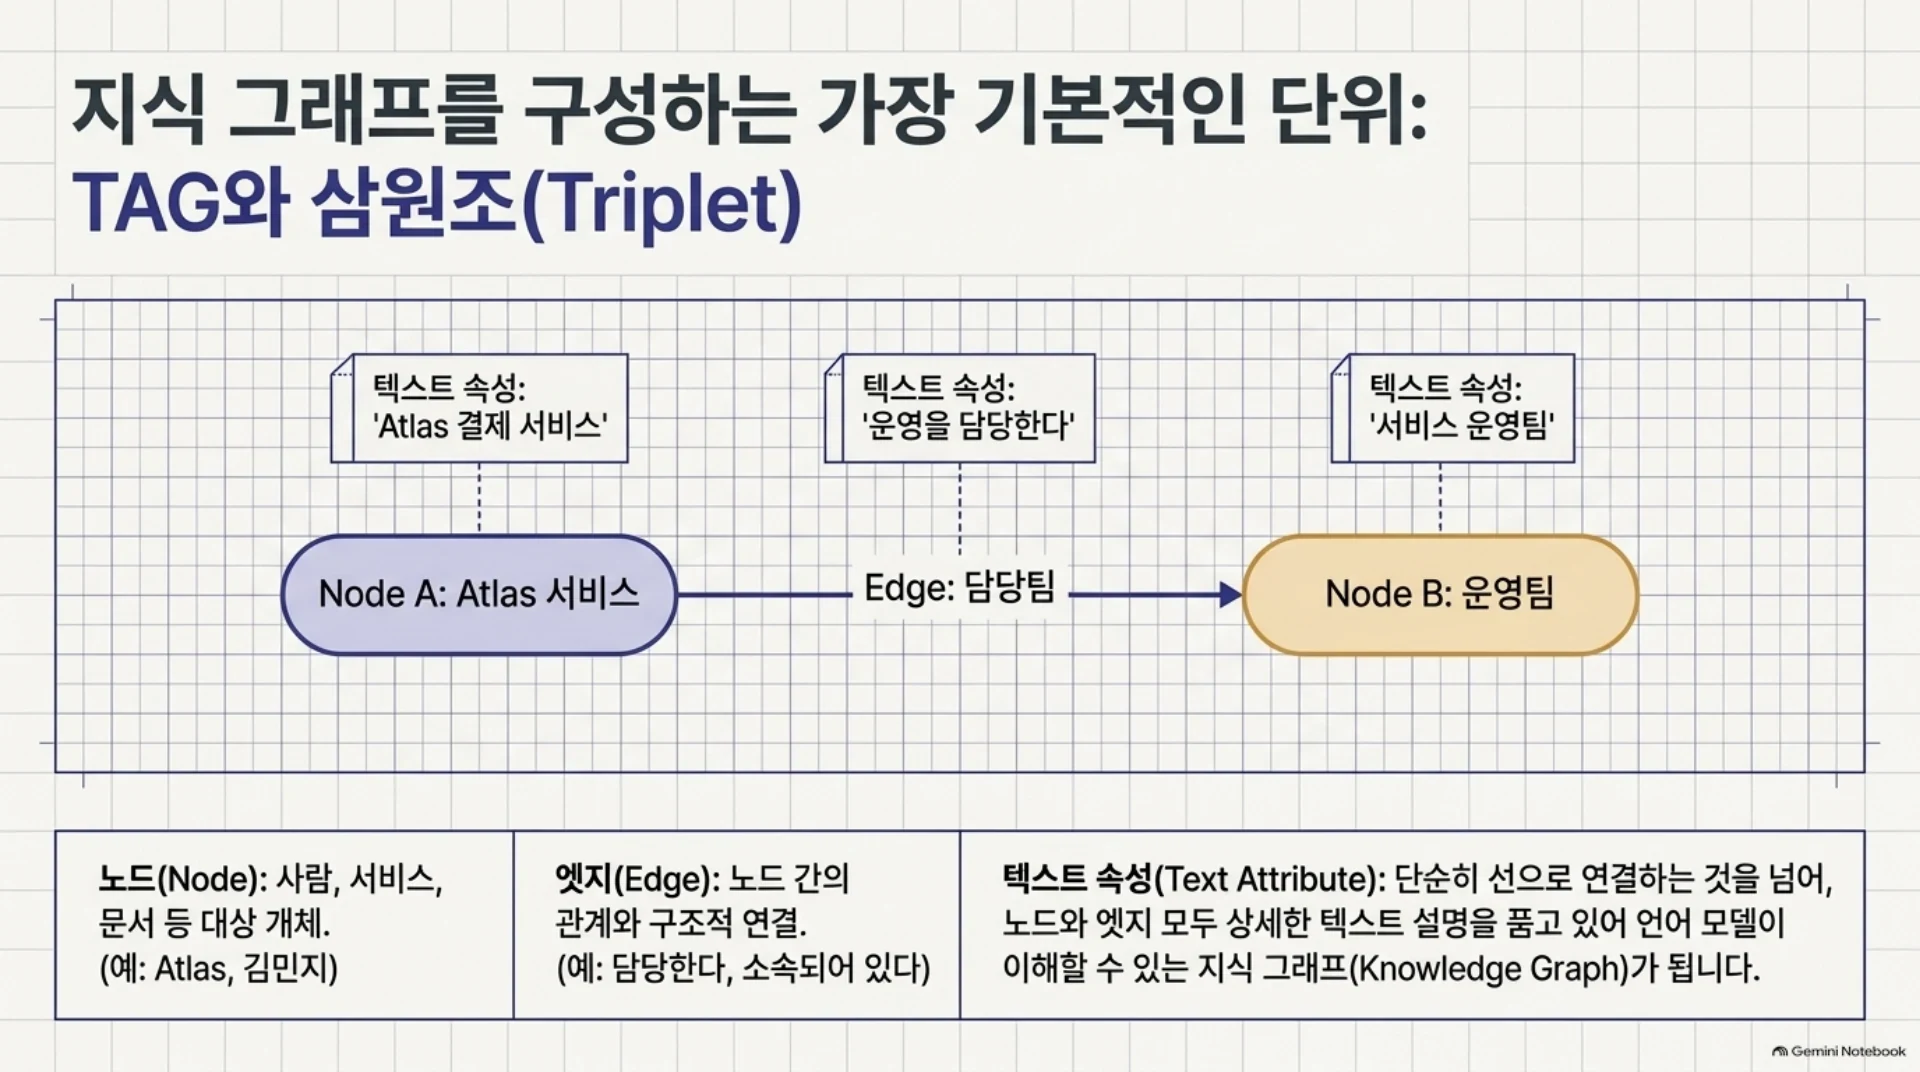
GraphRAG가 다루는 그래프를 Text-Attributed Graph(TAG)로 생각할 수 있습니다. 노드는 사람, 서비스, 문서 같은 대상을 나타내고, 엣지는 그 사이의 연결을 나타냅니다. 여기에 노드와 엣지 각각이 텍스트 속성을 가집니다.
노드: Atlas 서비스        텍스트 속성: "Atlas 결제 서비스"
엣지: 담당팀              텍스트 속성: "운영을 담당한다"
노드: 운영팀              텍스트 속성: "서비스 운영팀"

Atlas 서비스 ──담당팀──→ 운영팀
그래프에는 어떤 노드가 어떤 노드와 연결됐는지라는 구조도 있습니다. 인접 행렬은 이 구조를 0과 1로 나타낸 표입니다. 연결돼 있으면 1, 연결이 없으면 0입니다. 노드와 엣지 목록으로 보는 방식과 행렬로 보는 방식은 같은 연결 정보를 다르게 표현한 것입니다.
Knowledge Graph(KG)는 TAG의 대표적인 형태입니다. 노드를 개체로, 엣지를 개체 간 관계로 사용합니다. 예를 들어 Alice ─LivesIn→ New York, Alice ─WorksAt→ Google이라는 그래프에서는 이름이 노드의 텍스트가 되고, LivesIn, WorksAt은 관계 이름이 됩니다. since 2020, as Software Engineer처럼 관계에 붙는 설명도 엣지 속성이 될 수 있습니다.
GNN은 주변 정보를 어떻게 모으나
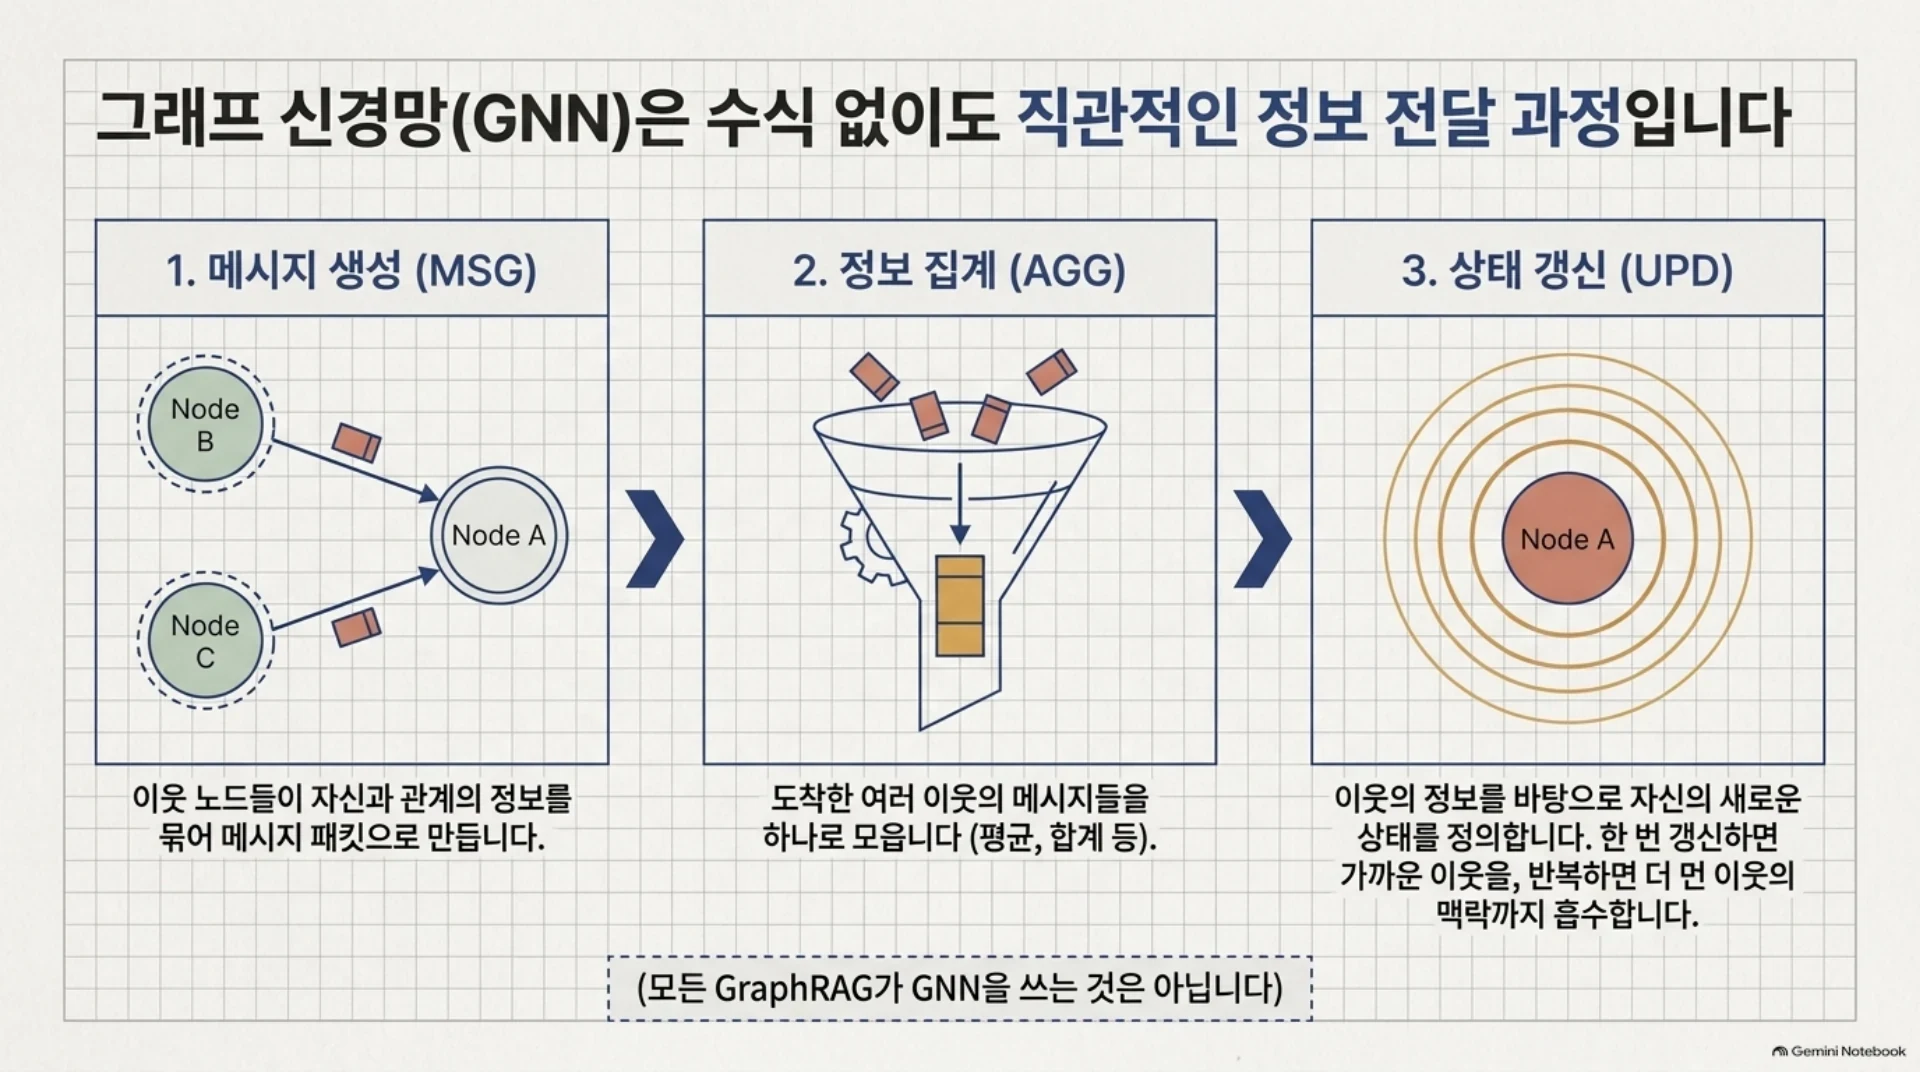
Graph Neural Network(GNN)는 그래프의 연결을 이용해 노드의 표현을 갱신합니다. GCN, GAT, GraphSAGE 같은 모델이 이웃에서 정보를 받아 합치는 message passing을 사용합니다.
B ──관계──→ A ←──관계── C

1. B와 C에서 A에게 보낼 정보를 만든다.     MSG
2. 두 메시지를 평균, 합계, 최대값 등으로 합친다. AGG
3. 합친 정보와 A의 기존 정보를 이용해 A를 갱신한다. UPDMSG는 양쪽 노드의 정보와 그 사이 관계를 보고 메시지를 만듭니다. AGG는 여러 이웃의 메시지를 하나로 모읍니다. UPD는 그 결과를 이용해 노드 A의 새 표현을 만듭니다. 한 번 갱신하면 가까운 이웃의 정보가 반영되고, 여러 층을 거치면 더 먼 이웃의 정보까지 들어올 수 있습니다. 모든 GraphRAG가 GNN을 쓰는 것은 아닙니다. GNN은 뒤에서 살펴볼 검색기 구현 방법 중 하나입니다.
3. GraphRAG의 전체 동작
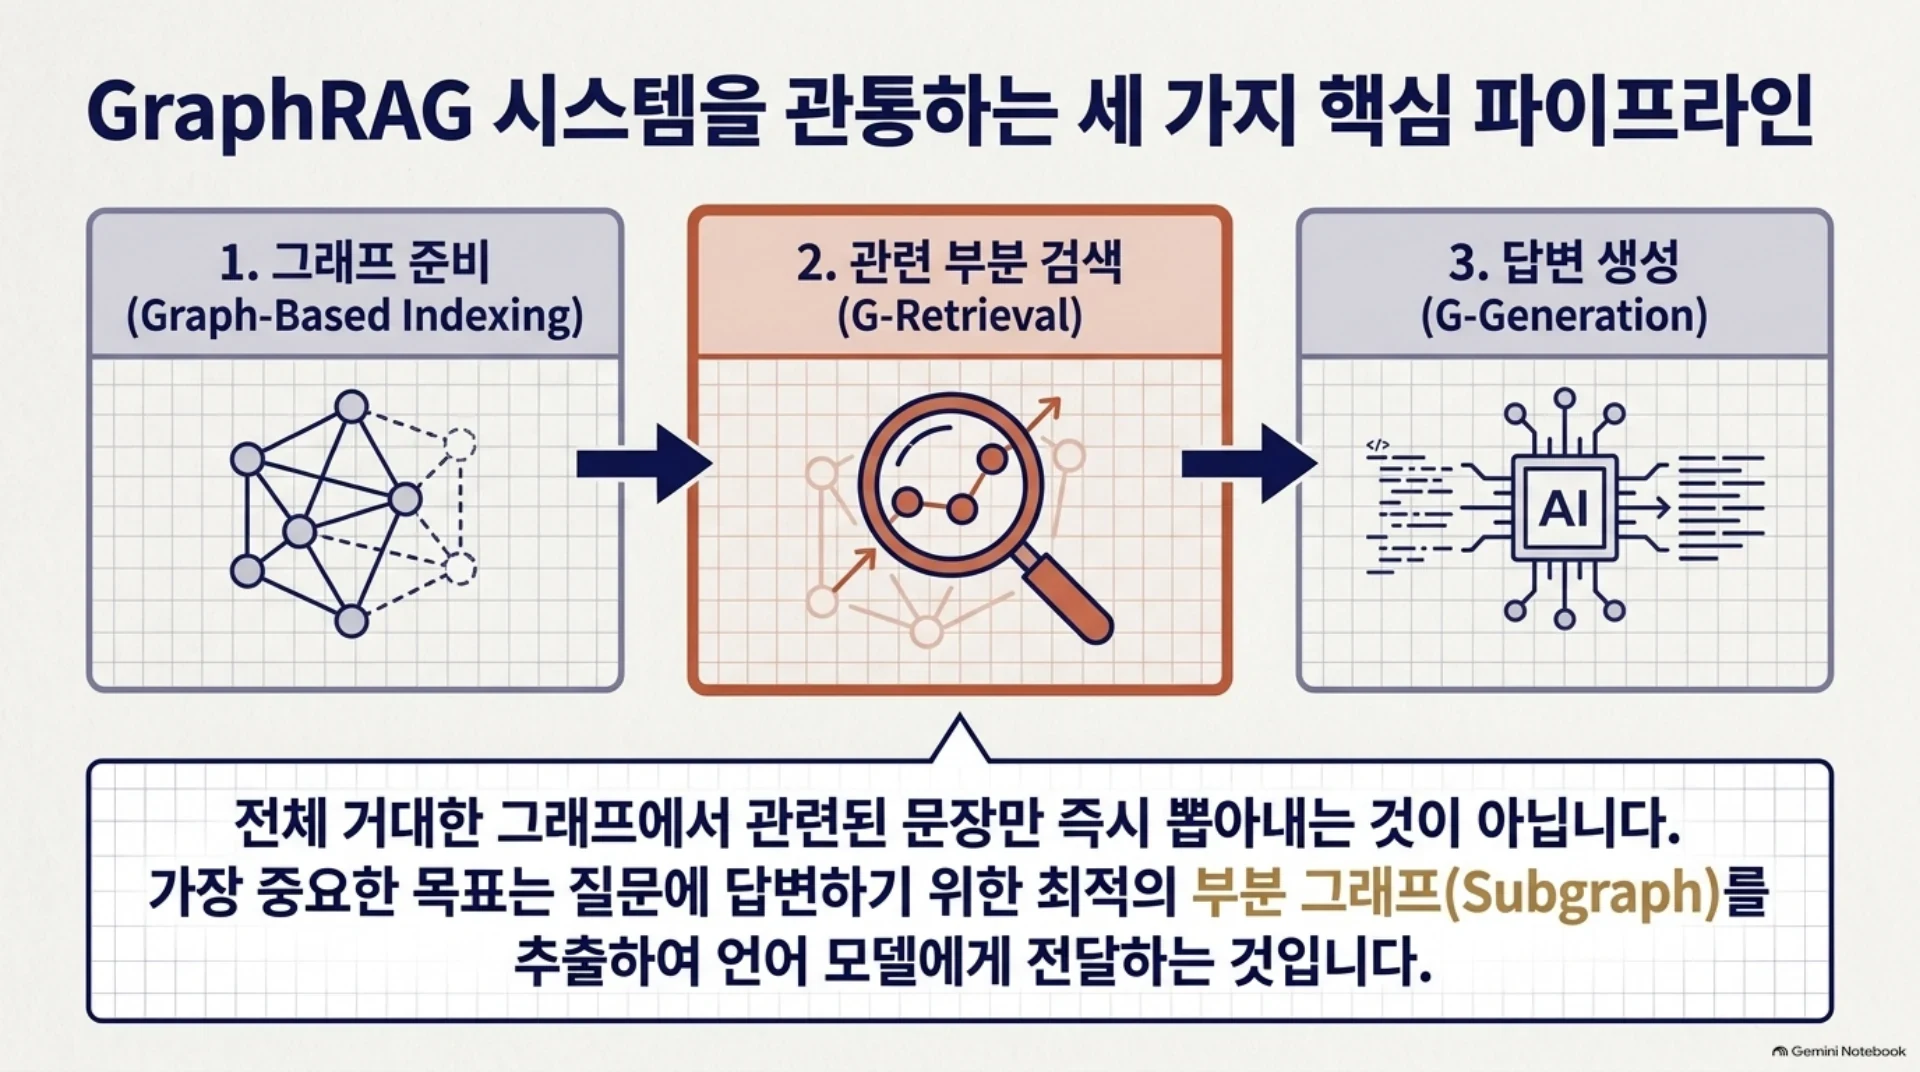
가장 큰 흐름은 그래프 준비 → 관련 부분 검색 → 답변 생성입니다. 질문에 대한 답이 될 만한 문장을 곧장 쓰기 전에, 큰 그래프에서 필요한 부분 그래프를 고릅니다.
질문 + 전체 그래프
       ↓
Graph Retriever: 질문과 관련된 연결을 고른다
       ↓
부분 그래프
       ↓
Answer Generator: 선택한 관계를 읽고 답한다
이를 조금 더 자세히 보면 세 작업으로 나뉩니다.
- Graph-Based Indexing: 그래프를 만들거나 가져와 노드, 엣지, 텍스트 속성에 접근할 수 있도록 인덱스를 준비합니다.
- Graph-Guided Retrieval, G-Retrieval: 질문에 관련된 노드, triplet, 경로, 부분 그래프를 찾습니다. 검색 범위를 먼저 좁히고 관련성을 비교할 수도 있습니다.
- Graph-Enhanced Generation, G-Generation: 찾은 그래프를 LLM이 읽을 수 있게 변환하고 질문과 함께 넣어 답변을 만듭니다.
이론적으로는 여러 부분 그래프가 답변에 도움이 될 가능성을 모두 고려할 수 있습니다. 실제 흐름을 이해할 때는 질문에 가장 도움이 되는 작은 부분을 찾아 답의 근거로 쓴다고 생각하면 충분합니다. 이때 “가장 좋은 부분 그래프”는 목표를 설명하는 표현이지, 검색기가 언제나 진짜 최적해를 찾아낸다는 보장은 아닙니다.
4. 그래프의 재료와 인덱싱
그래프의 출처는 크게 이미 존재하는 그래프와 직접 만드는 그래프로 나뉩니다. 공개된 일반 지식 그래프에는 Wikidata, Freebase, DBpedia, YAGO처럼 백과사전형 자료와 ConceptNet, ATOMIC처럼 상식 관계를 다루는 자료가 있습니다. 특정 분야에는 의생명 자료인 CMeKG, CPubMed-KG, 영화 관련 Wiki-Movies가 있습니다. GR-Bench, GraphQA 같은 이름은 여러 분야의 그래프 질문과 평가 맥락에서 등장합니다.
사내 Wiki에는 회사만 아는 서비스, 정책, 조직, 장애 이력이 많으므로 문서와 표, 데이터베이스에서 그래프를 직접 만드는 편이 자연스러울 수 있습니다. 만드는 방식은 한 가지가 아닙니다.
| 그래프에 넣을 연결 | 만드는 방법 | 예시 |
|---|---|---|
| 문서 사이 관계 | 같은 문서를 인용하거나 같은 주제를 다루는 문서 연결 | 장애 대응 정책 ↔ 온콜 절차 |
| 문단 사이 관계 | 공통 키워드나 다른 연결 근거를 가진 문단 연결 | Atlas 소개 ↔ Atlas 장애 절차 |
| 개체 사이 관계 | NER나 언어 모델로 개체와 관계 추출 | Atlas → 담당팀 → 운영팀 |
문서 관계 그래프와 개체 관계 그래프는 노드의 크기부터 다릅니다. 어떤 시스템은 문서 한 개를 노드로 쓰고, 다른 시스템은 문서 안의 사람이나 서비스를 노드로 씁니다. 이 선택은 뒤에서 얼마나 세밀하게 검색할 수 있는지를 결정합니다.
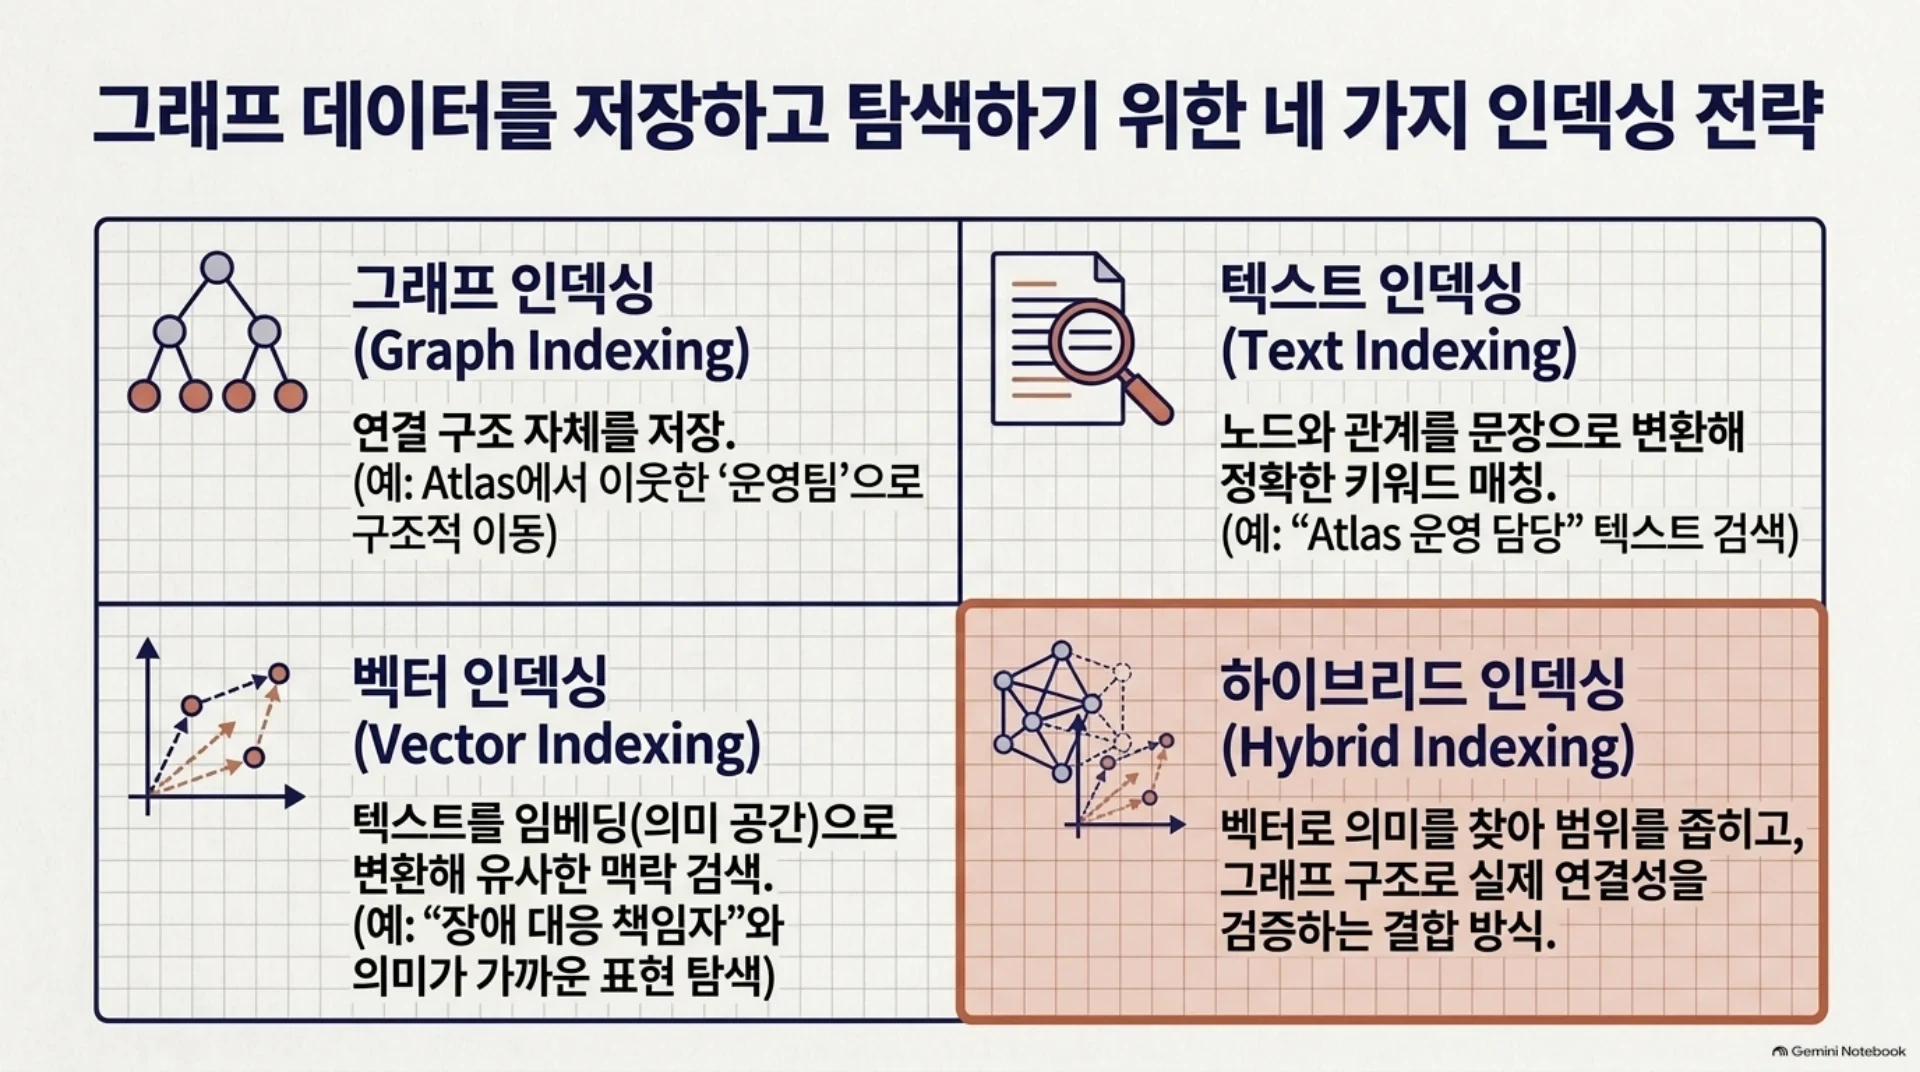
그래프를 만든 다음에는 인덱싱 방식을 고릅니다.
| 방식 | 무엇을 저장하고 찾나 | 예시 질문에서 하는 일 |
|---|---|---|
| Graph Indexing | 연결 구조와 이웃을 빠르게 따라갈 수 있게 저장 | Atlas에서 담당팀, 팀장으로 이동 |
| Text Indexing | 노드와 관계를 문장으로 바꿔 텍스트 검색 | “Atlas 운영 담당”이라는 표현 검색 |
| Vector Indexing | 노드와 관계의 텍스트를 임베딩해 의미가 가까운 후보 검색 | “장애 대응 책임자”와 비슷한 표현 찾기 |
| Hybrid Indexing | 그래프, 텍스트, 벡터 검색을 결합 | 의미로 후보를 찾고 관계를 따라 검증 |
Vector Indexing에서는 가까운 벡터를 찾기 위해 k-NN 검색을 사용하고, LSH 같은 근사 기법을 적용할 수 있습니다. 이 단계의 목적은 나중에 필요한 노드와 관계를 빠르게 찾을 수 있게 준비하는 것입니다.
5. 질문이 들어오면 검색 범위를 어떻게 좁히나
질문은 Wiki에 쓰인 말과 다를 수 있습니다. “장애 대응 책임자”라는 질문을 온콜 담당, incident owner 같은 표현으로 넓히는 query expansion, “서비스 담당팀은 어디이며 그 팀장은 누구인가?”처럼 작은 질문으로 나누는 query decomposition이 검색 전에 도움이 될 수 있습니다. 다만 무작정 확장하면 관련 없는 정보도 늘어납니다. 이런 질문 보강은 그래프 검색 앞에 놓일 수 있는 선택 사항입니다.
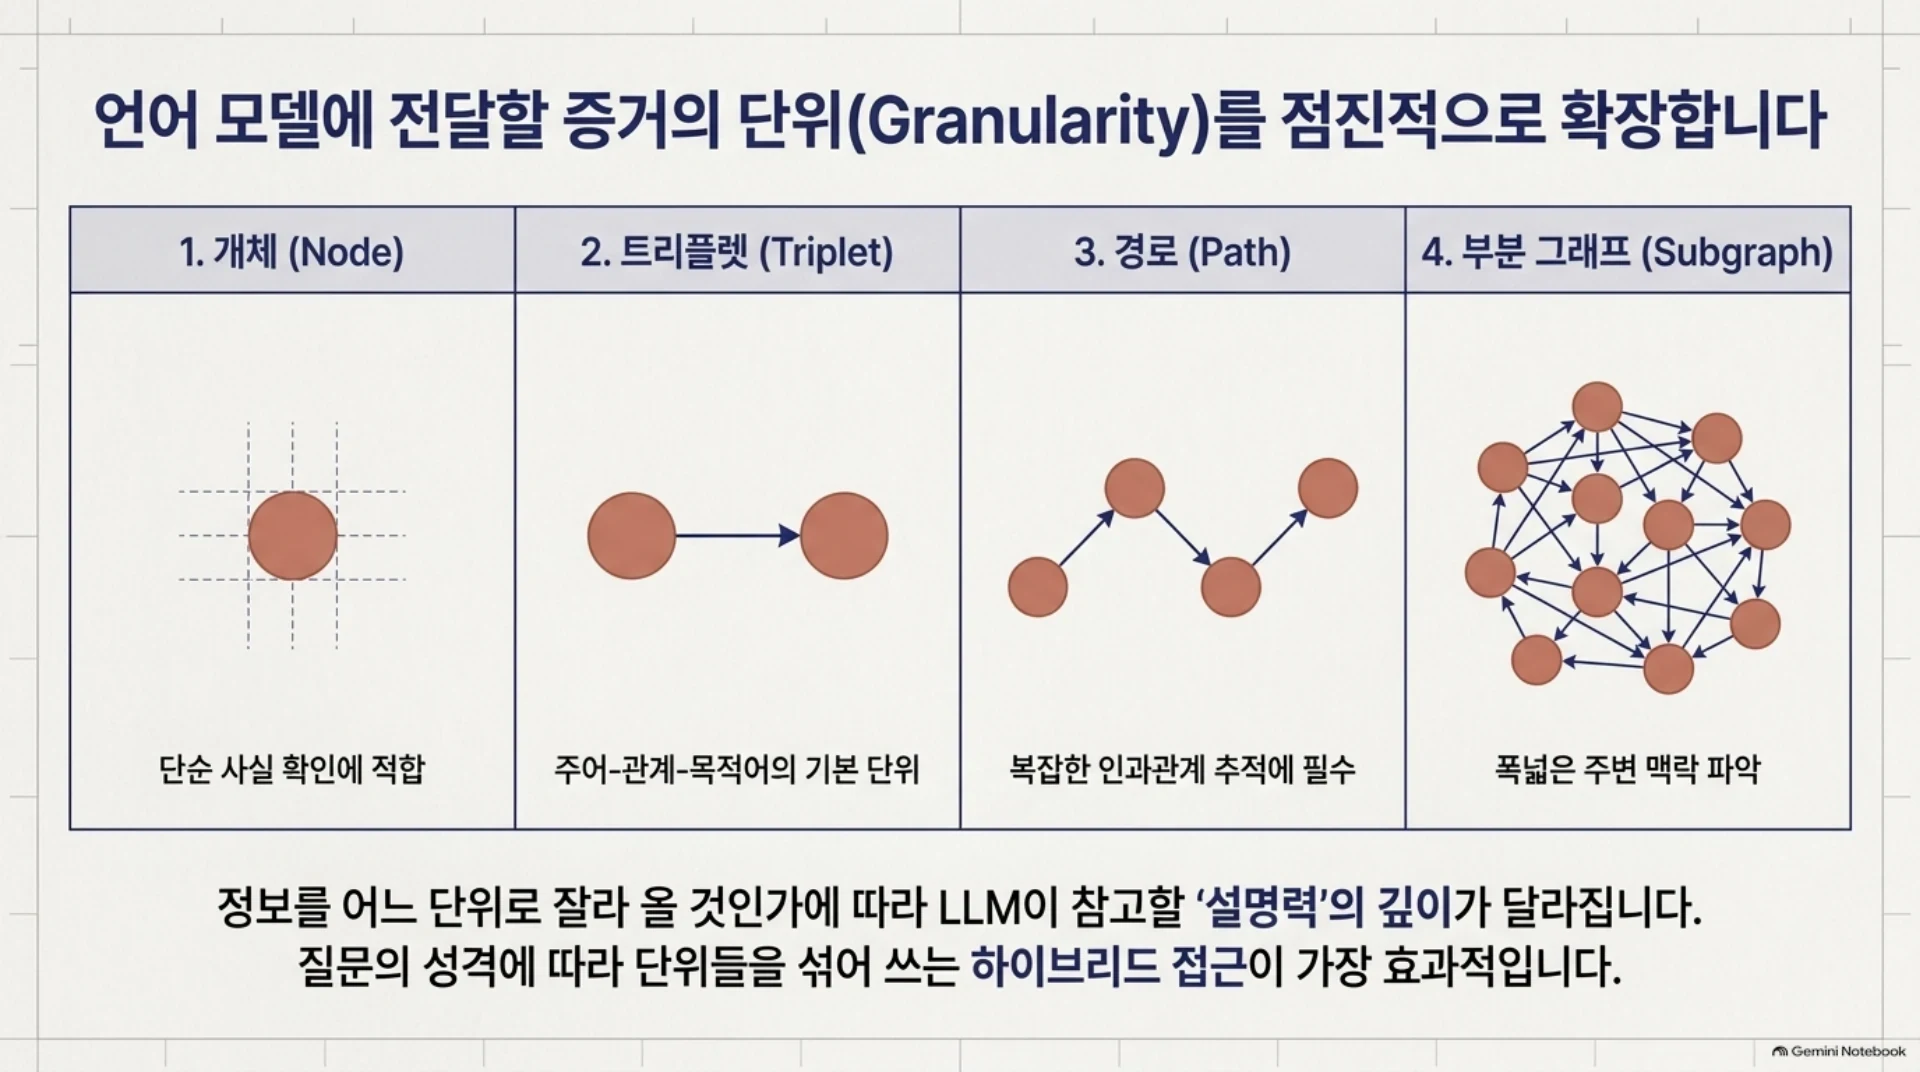
검색기는 무엇을 가져올지도 정해야 합니다. 노드 한 개만 가져올지, 관계 하나를 나타내는 triplet을 가져올지, 여러 관계가 이어진 경로나 부분 그래프를 가져올지에 따라 결과의 크기와 설명력이 달라집니다. 검색 후에는 중복된 관계를 합치고(knowledge merging), 관련성이 낮은 관계를 덜어낼(knowledge pruning) 수 있습니다.
규칙과 그래프 탐색으로 찾기
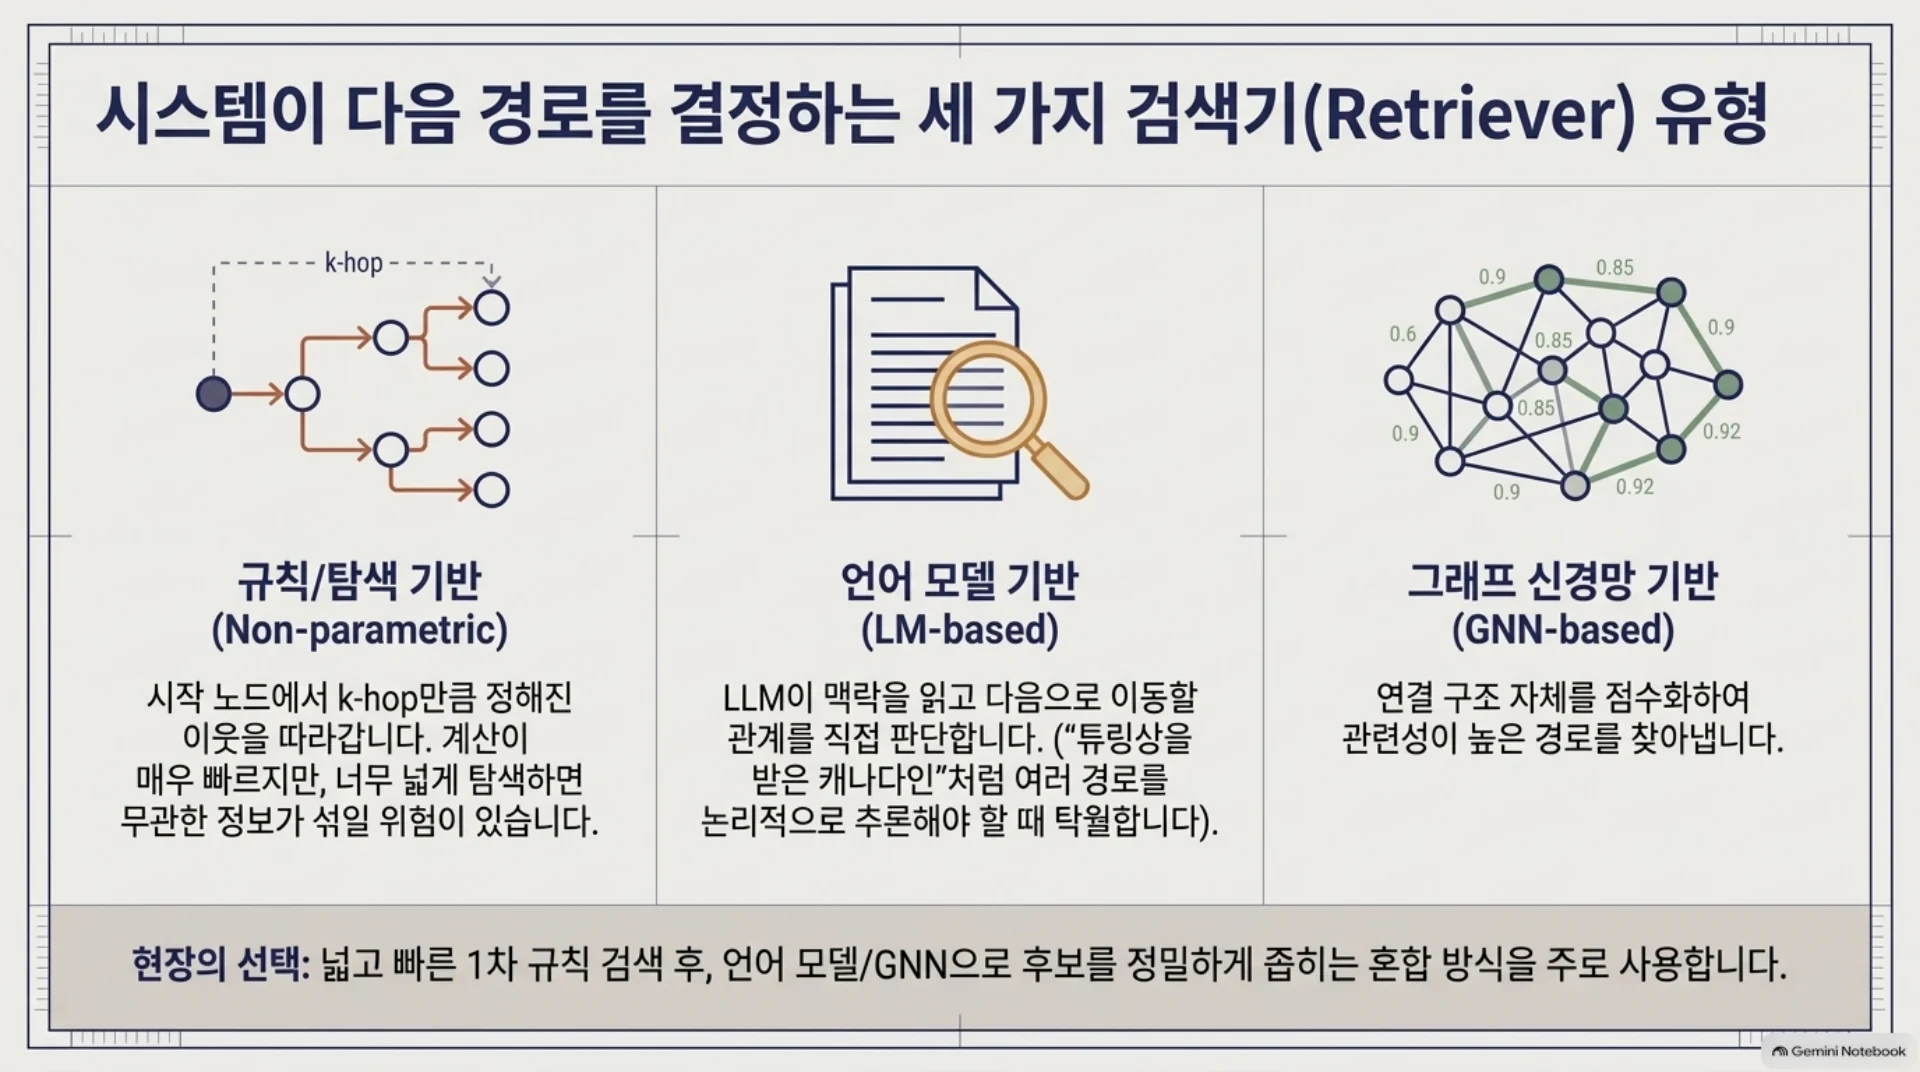
Non-parametric Retriever는 학습한 깊은 모델 없이 규칙과 그래프 탐색을 사용합니다. 먼저 질문의 표현을 그래프 노드에 연결하는 entity linking을 하고, 시작 노드에서 k-hop만큼 이웃을 따라갑니다. 한 hop은 관계 하나를 지나는 이동입니다. Atlas → 운영팀 → 김민지는 두 hop입니다.
주제 개체를 포함한 경로를 가져오거나, 관련성이 높은 노드와 엣지를 비용을 너무 키우지 않으면서 연결하려는 PCST(Prize-Collecting Steiner Tree) 계열 방법을 사용할 수도 있습니다. 규칙 검색은 빠르지만 시작 노드를 잘못 찾거나 관계를 너무 넓게 따라가면 답과 무관한 경로가 섞입니다.
“회전문은 양방향 통행에 편리하지만 어디에서 보안 수단이 되나?”라는 선택형 질문을 떠올려 보겠습니다. 그래프에 door, security, robber, bank, travel 같은 개체가 있어도 모두 똑같이 중요하지는 않습니다. 질문 맥락에서는 보안과 은행으로 이어지는 개체의 관련성이 더 높습니다. 그래프에 존재한다는 것과 이번 질문의 근거로 적합하다는 것은 다른 판단입니다.
언어 모델로 다음 관계를 고르기
LM-based Retriever는 모델이 질문을 읽고 어떤 관계를 더 따라갈지 판단합니다.
| 방법 | 검색기가 하는 일 |
|---|---|
| Subgraph Retriever | RoBERTa로 주제 개체에서 출발해 관련 경로를 순서대로 확장 |
| KG-GPT | LLM이 특정 개체에서 관련성이 높은 상위 K개 관계를 선택 |
| StructGPT | LLM이 Extract Neighbor Relations 같은 미리 정의된 함수를 호출해 이웃 관계를 검색하고 결과를 결합 |
“튜링상을 받은 캐나다 시민은 어디를 졸업했나?”라는 질문은 한 개체만 찾으면 끝나지 않습니다. 튜링상 수상 경로와 캐나다 시민 경로를 각각 따라가 공통 인물을 찾고, 그 인물의 졸업 관계를 이어야 합니다. 이런 예에서는 각 출발점의 경로를 나중에 하나의 부분 그래프로 합치는 과정이 중요합니다.
GNN으로 관련성을 점수화하기
GNN-based Retriever는 노드의 연결 구조를 표현으로 만들고, 질문에 관련된 개체나 경로에 점수를 줍니다. GNN-RAG는 그래프를 인코딩하고 개체 점수를 매긴 뒤 기준을 넘는 후보를 검색합니다. EtD는 여러 번 경로를 확장하면서 LLaMA2가 현재 노드에서 따라갈 엣지를 고르고, GNN이 새로 만난 노드의 표현을 만듭니다.
규칙 기반은 대체로 계산이 가볍습니다. LM과 GNN 기반 방법은 질문 맥락과 그래프 구조를 더 자세히 반영할 수 있지만 계산 비용이 늘 수 있습니다. 어느 방식이 정확한지는 데이터와 질문, 구현에 따라 달라지므로, 넓고 빠른 1차 검색 뒤 더 비싼 방법으로 후보를 좁히는 혼합 또는 여러 단계의 검색도 사용합니다.
6. 복잡한 G-Retrieval 그림을 네 단계로 읽기
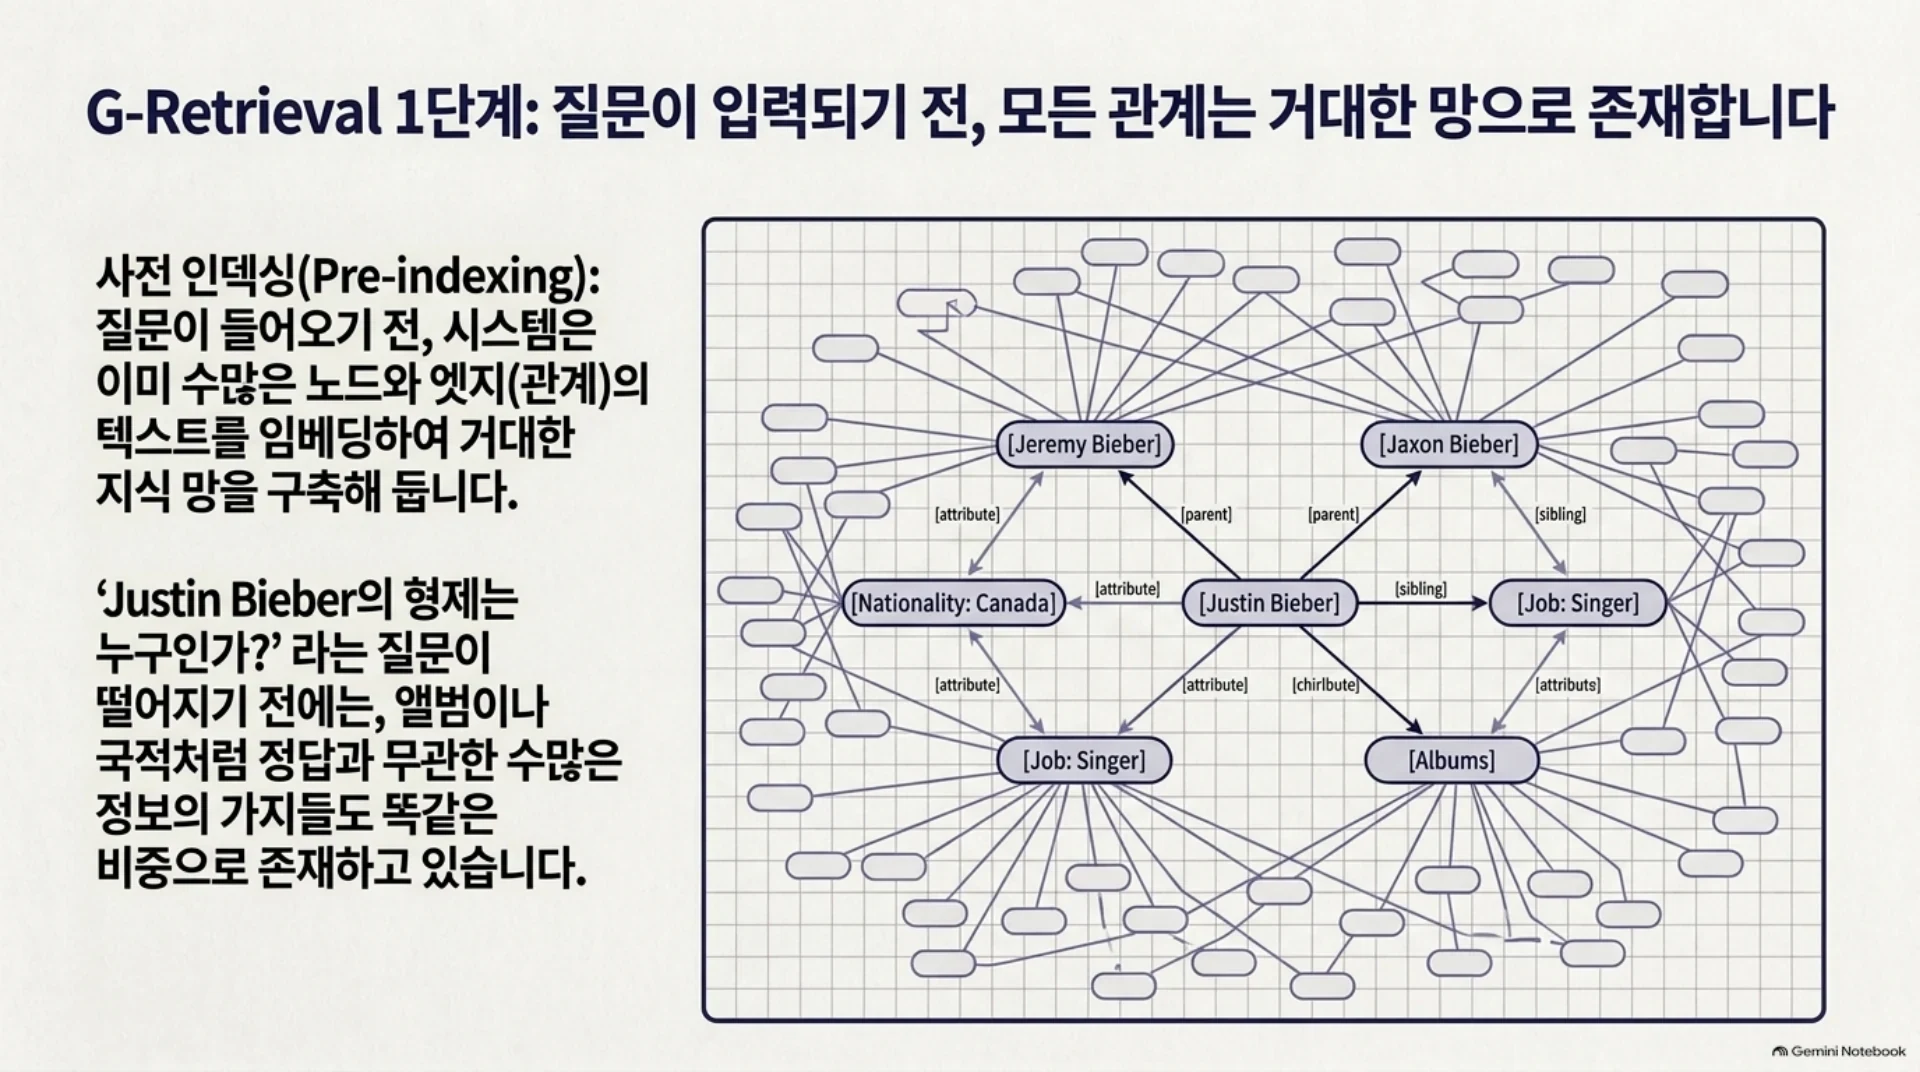
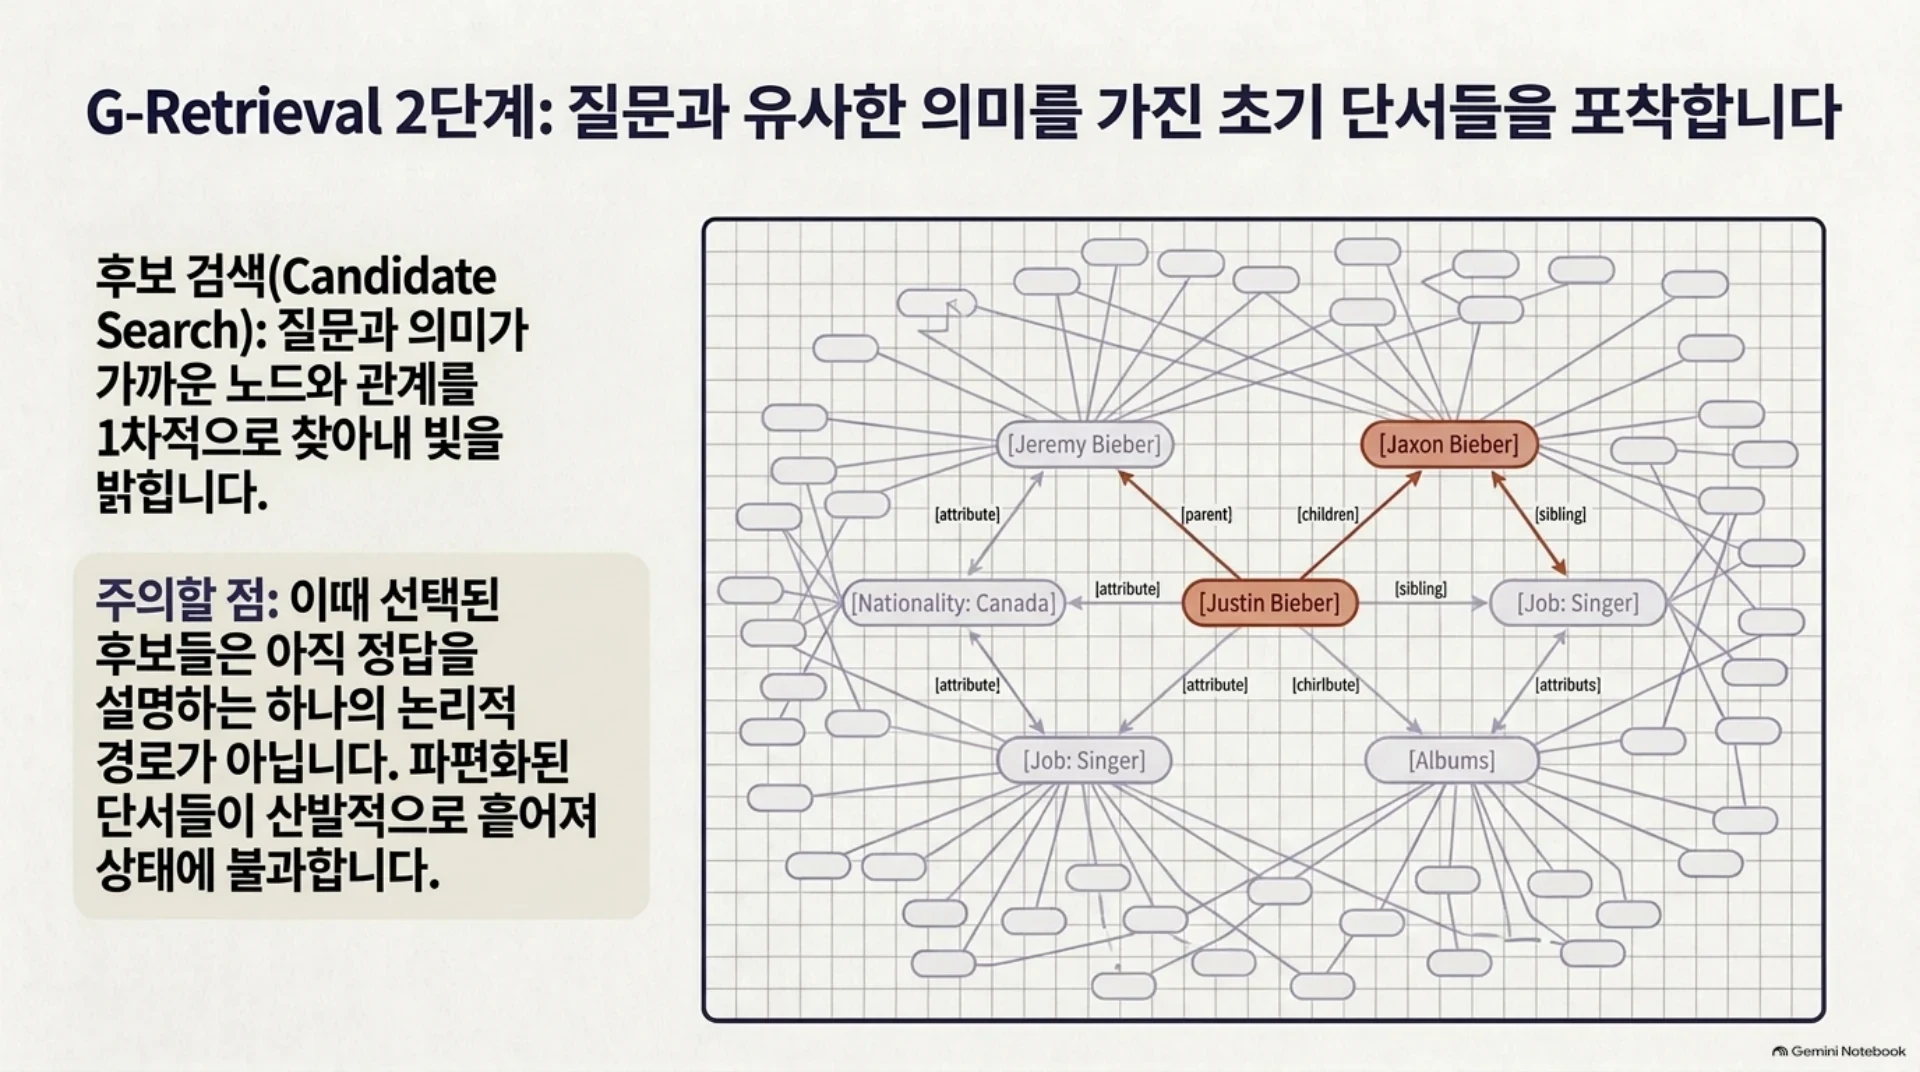
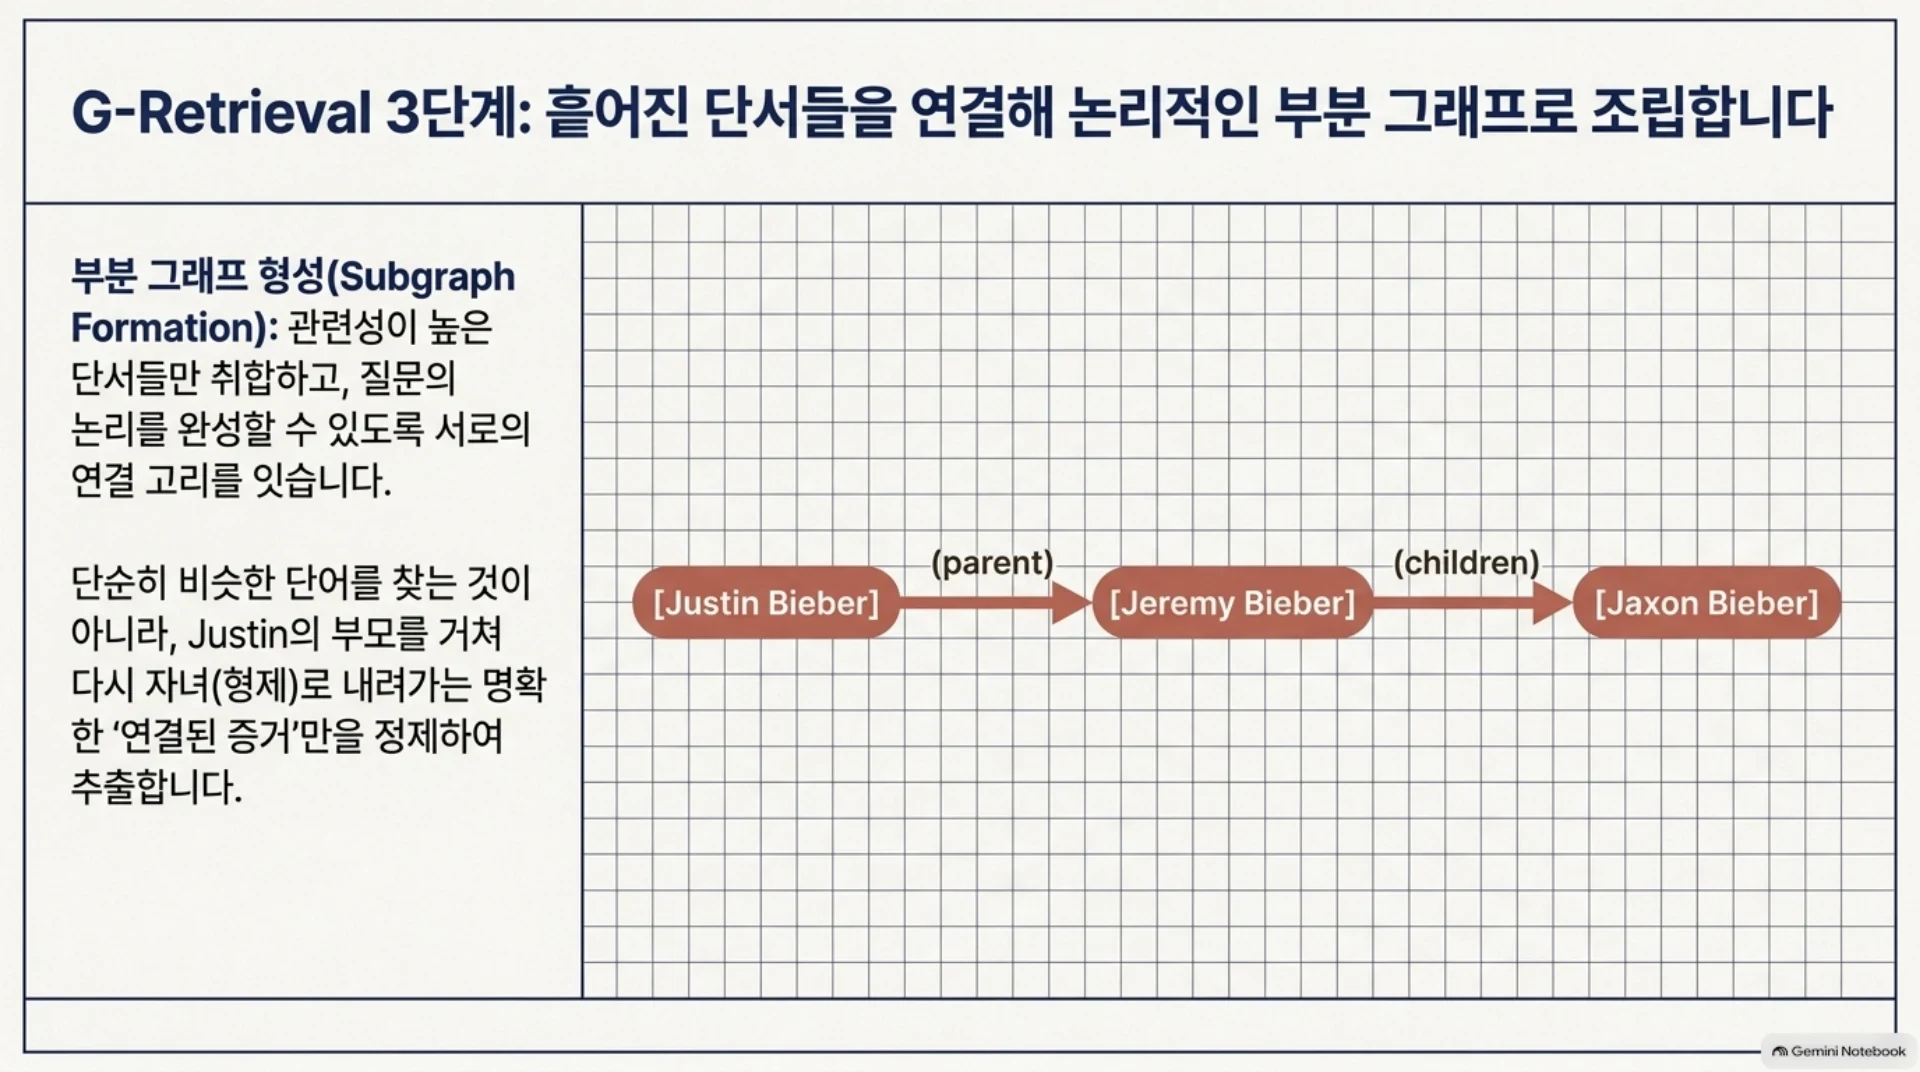
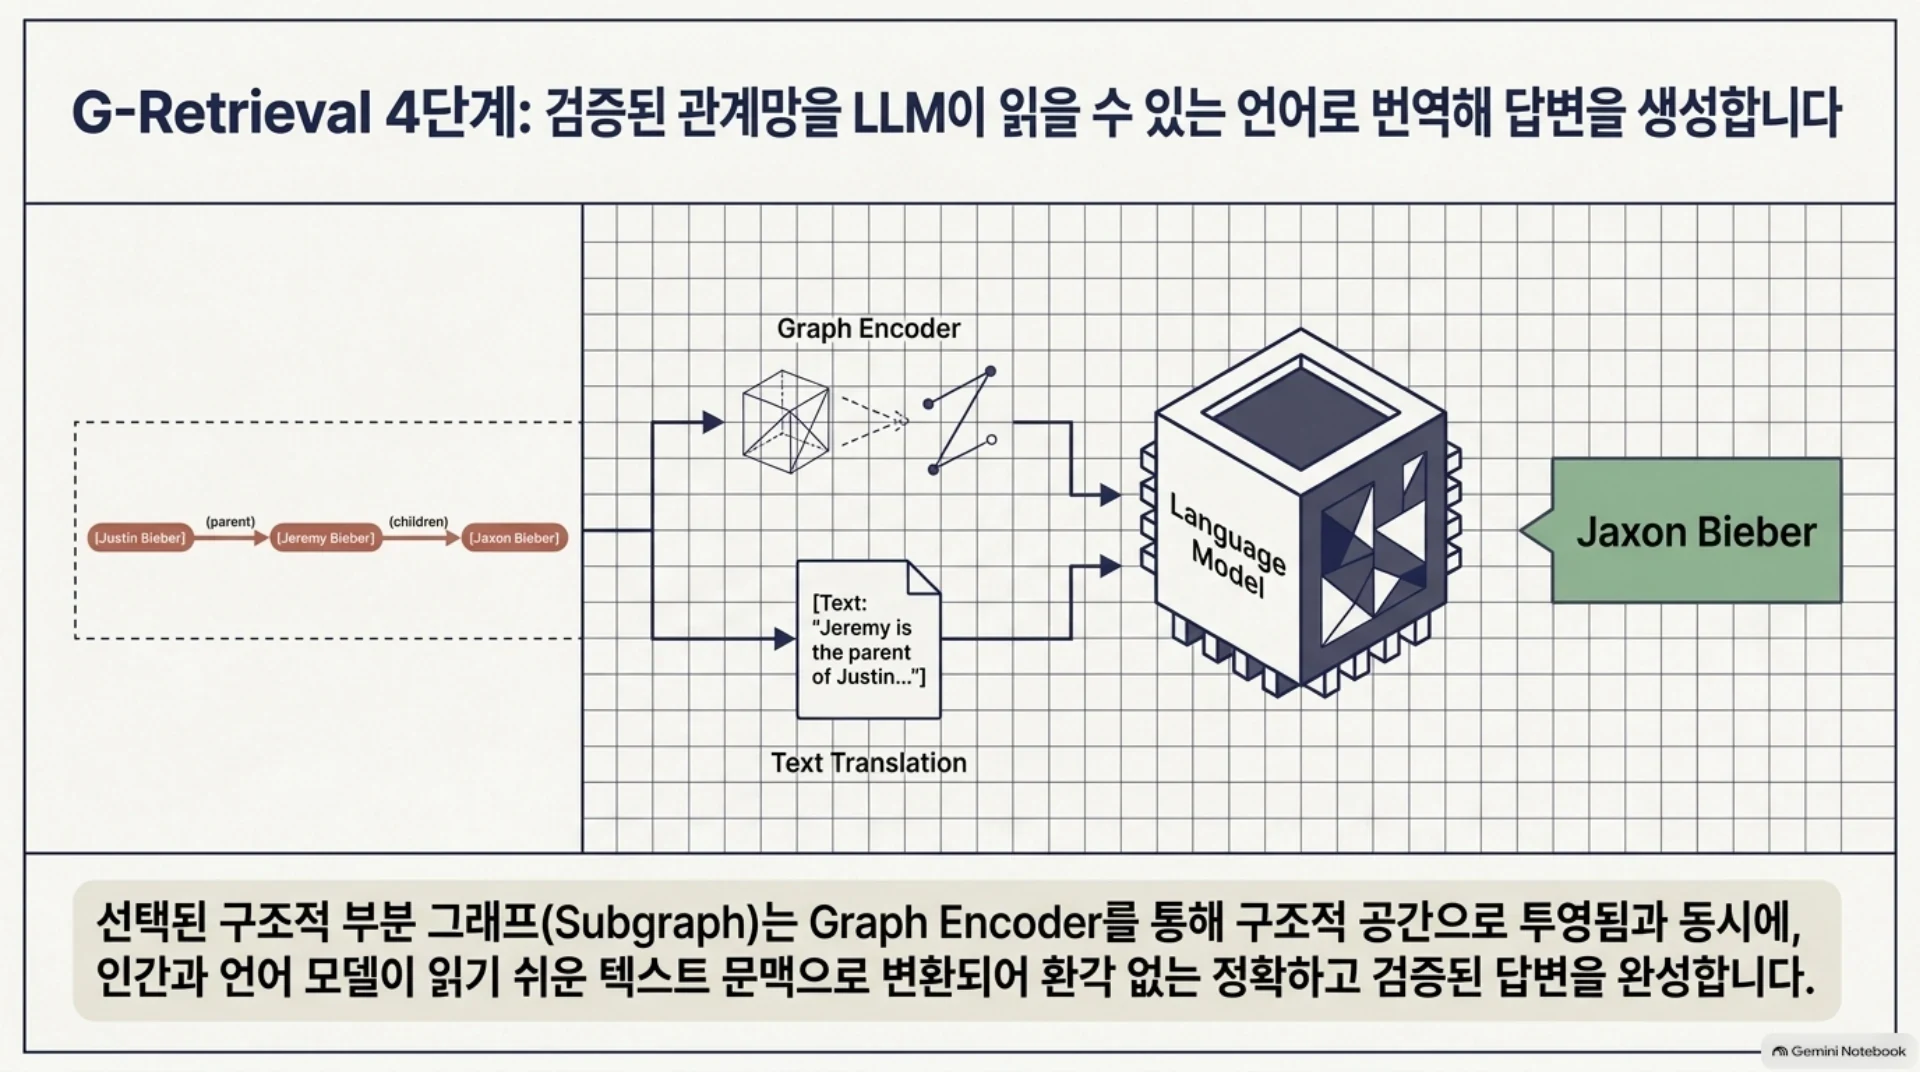
“Justin Bieber의 형제 이름은?”이라는 질문을 처리하는 그림에는 노드와 엣지 임베딩, 질문 검색, 부분 그래프 선택, Graph Encoder, LLM 입력이 한꺼번에 나옵니다. 이를 시간순으로 나누면 다음과 같습니다.
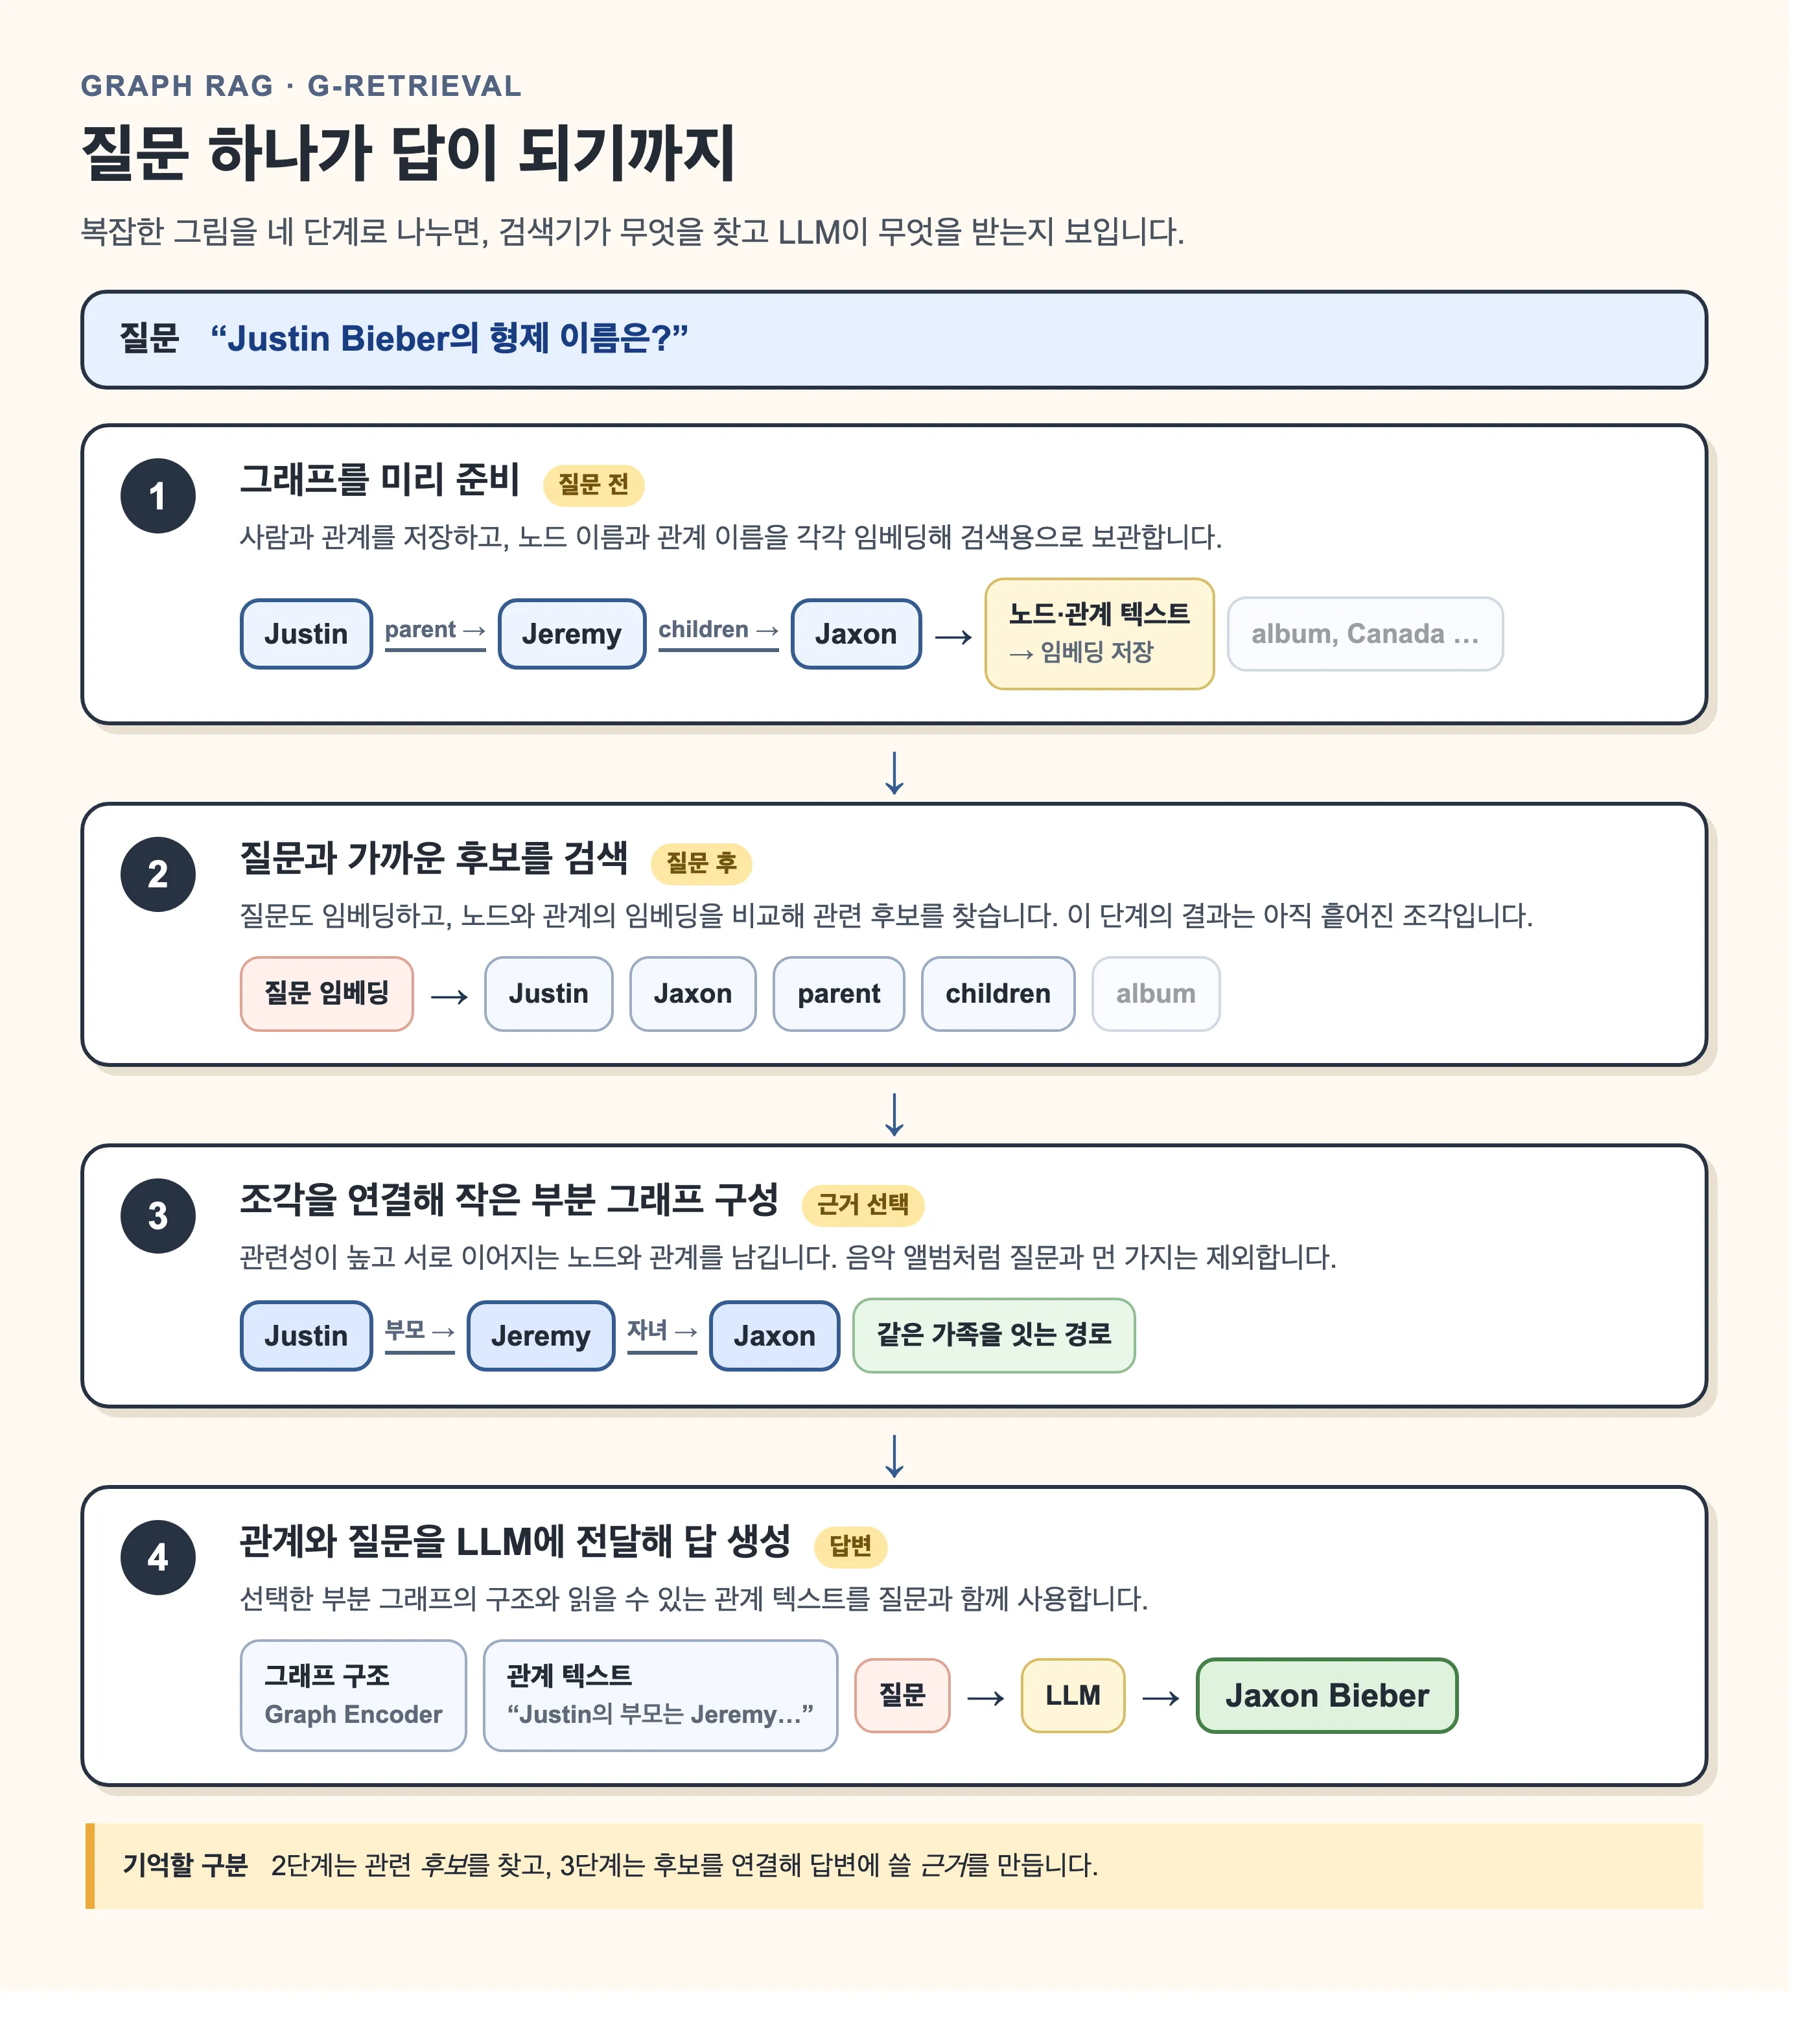
첫째, 질문이 오기 전에 인덱싱합니다. Justin Bieber, Jeremy Bieber, Jaxon Bieber 같은 노드와 parent, children, sibling 같은 관계의 텍스트를 임베딩해 저장합니다. 그래프의 연결 자체도 보존합니다. 앨범, 국적, 직업처럼 질문에 따라 중요하지 않을 수 있는 가지도 원래 그래프에는 존재합니다.
둘째, 질문과 가까운 후보를 찾습니다. 질문도 임베딩한 뒤 노드와 관계의 임베딩을 비교합니다. 이때 Justin, Jaxon, parent, children 등이 후보로 잡힐 수 있습니다. 후보 하나하나는 아직 답을 설명하는 연결된 증거가 아닙니다.
셋째, 후보를 작은 부분 그래프로 묶습니다. 서로 연결되고 질문과 관련성이 높은 노드와 엣지를 선택합니다. 예시에서는 Justin → 부모 Jeremy → 자녀 Jaxon이라는 가족 경로가 답에 도움을 줍니다. 앨범과 국적 같은 가지는 답변 근거에서 제외할 수 있습니다. 그림을 단순화하기 위해 식별자만 있는 다른 sibling 경로는 새 도식에서 생략했습니다.
넷째, 선택한 그래프로 답합니다. 한 경로는 Graph Encoder가 연결 구조를 표현하고 LLM이 사용할 공간으로 투영합니다. 다른 경로는 부분 그래프의 노드와 엣지를 읽을 수 있는 텍스트로 만듭니다. 질문과 이 정보들이 답변 모델에 들어갑니다. 예시 답은 Jaxon Bieber입니다.
이 그림에서 가장 헷갈리기 쉬운 지점은 2단계의 후보 검색과 3단계의 근거 구성입니다. 비슷해 보이는 개체를 찾는 것만으로는 답이 성립하지 않습니다. 그 개체들이 어떤 관계로 이어지는지 확인해야 합니다.
7. 한 번 찾을까, 결과를 보고 다시 찾을까
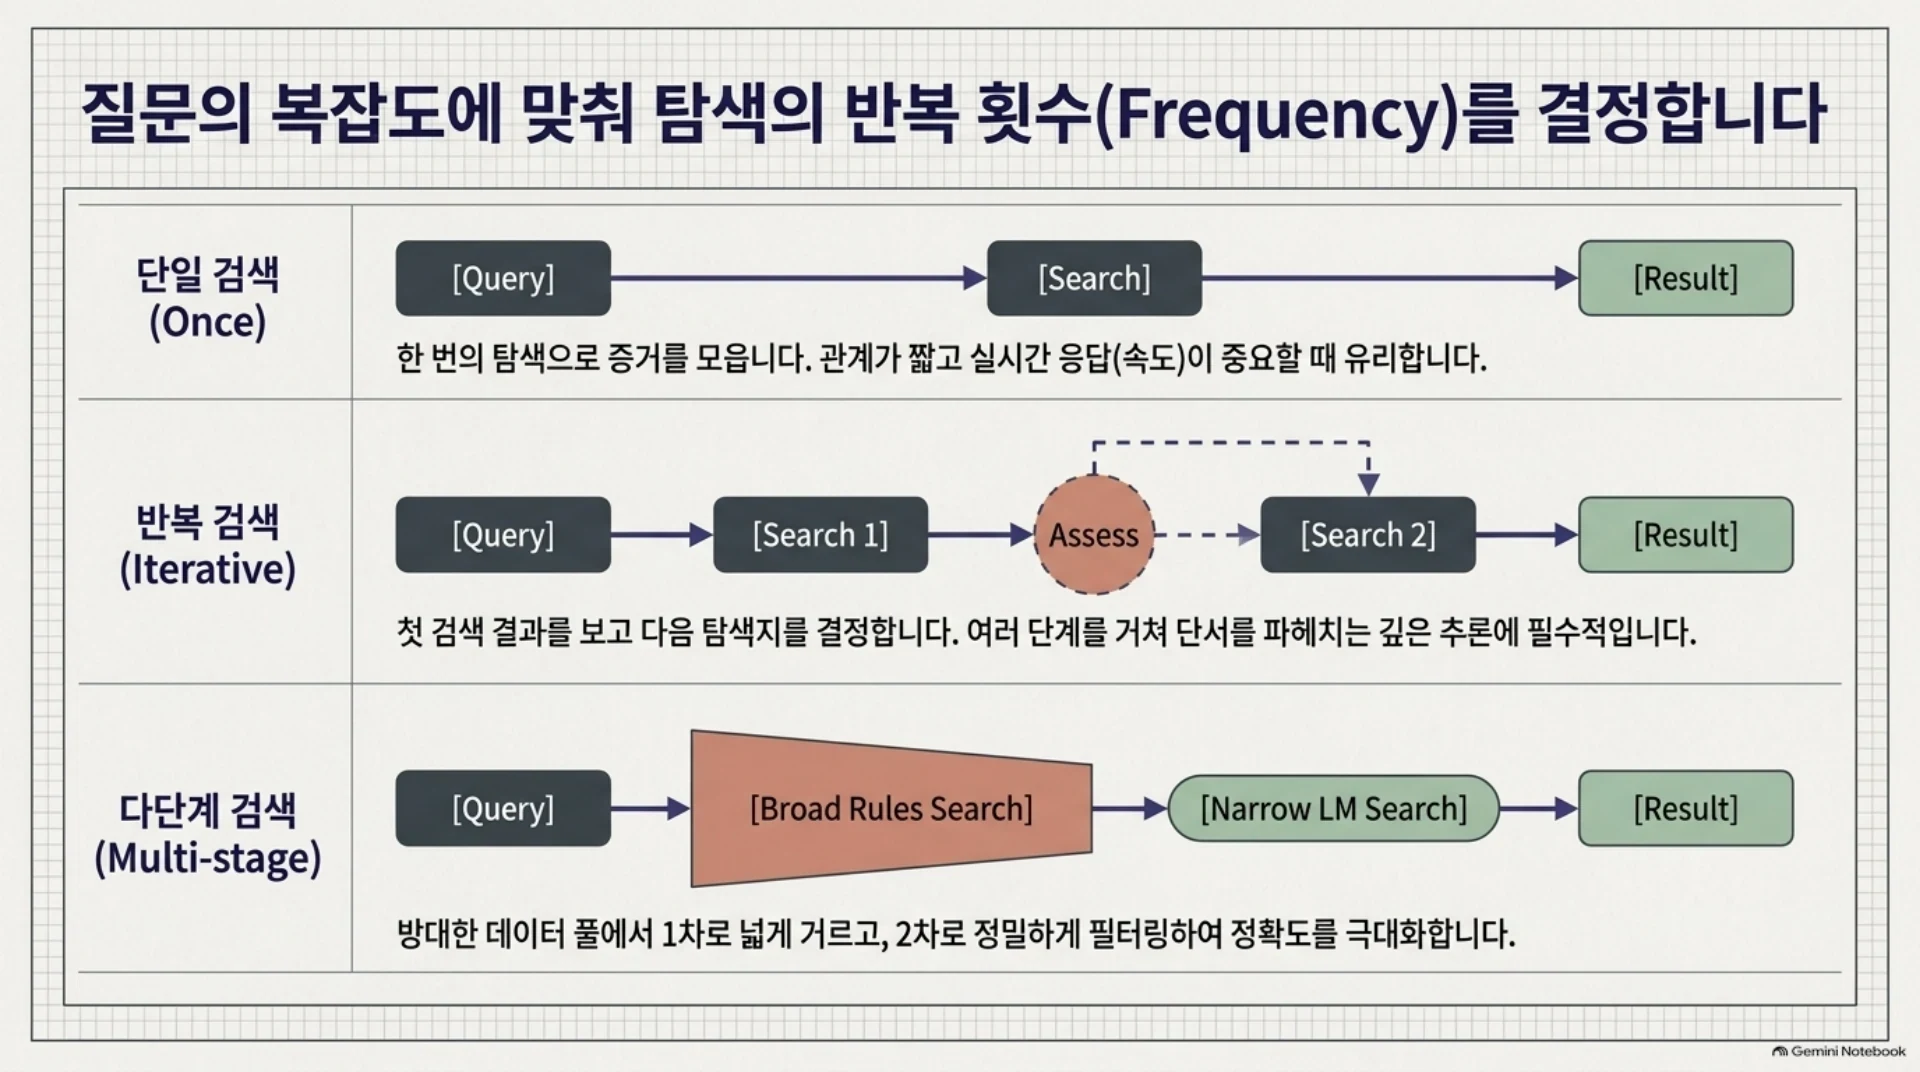
검색 횟수에 따라 세 가지 흐름이 있습니다.
| 방식 | 동작 | 어울리는 질문 | 부담 |
|---|---|---|---|
| Once Retrieval | 한 번의 검색 과정에서 필요한 근거를 모음 | 관계가 짧고 응답 시간이 중요한 질문 | 상대적으로 빠름 |
| Iterative Retrieval | 앞서 찾은 결과를 보고 다음 검색을 결정 | 여러 hop을 거치는 질문 | 검색 단계가 늘어남 |
| Multi-stage Retrieval | 단계마다 다른 검색기를 사용 | 후보가 많아 먼저 넓게 찾고 나중에 정밀하게 골라야 할 때 | 설계와 계산이 더 필요 |
Once Retrieval도 내부 방법은 다양합니다. 임베딩 유사도로 후보를 찾을 수 있고, 규칙으로 특정 triplet이나 부분 그래프를 추출할 수도 있습니다. LLM이 가능한 추론 경로를 여러 개 제안한 뒤 각각 독립적으로 검색해 결과를 모으는 방식도 있습니다. 핵심은 앞선 검색 결과에 따라 다음 검색을 바꾸는 반복 과정을 두지 않는다는 점입니다.
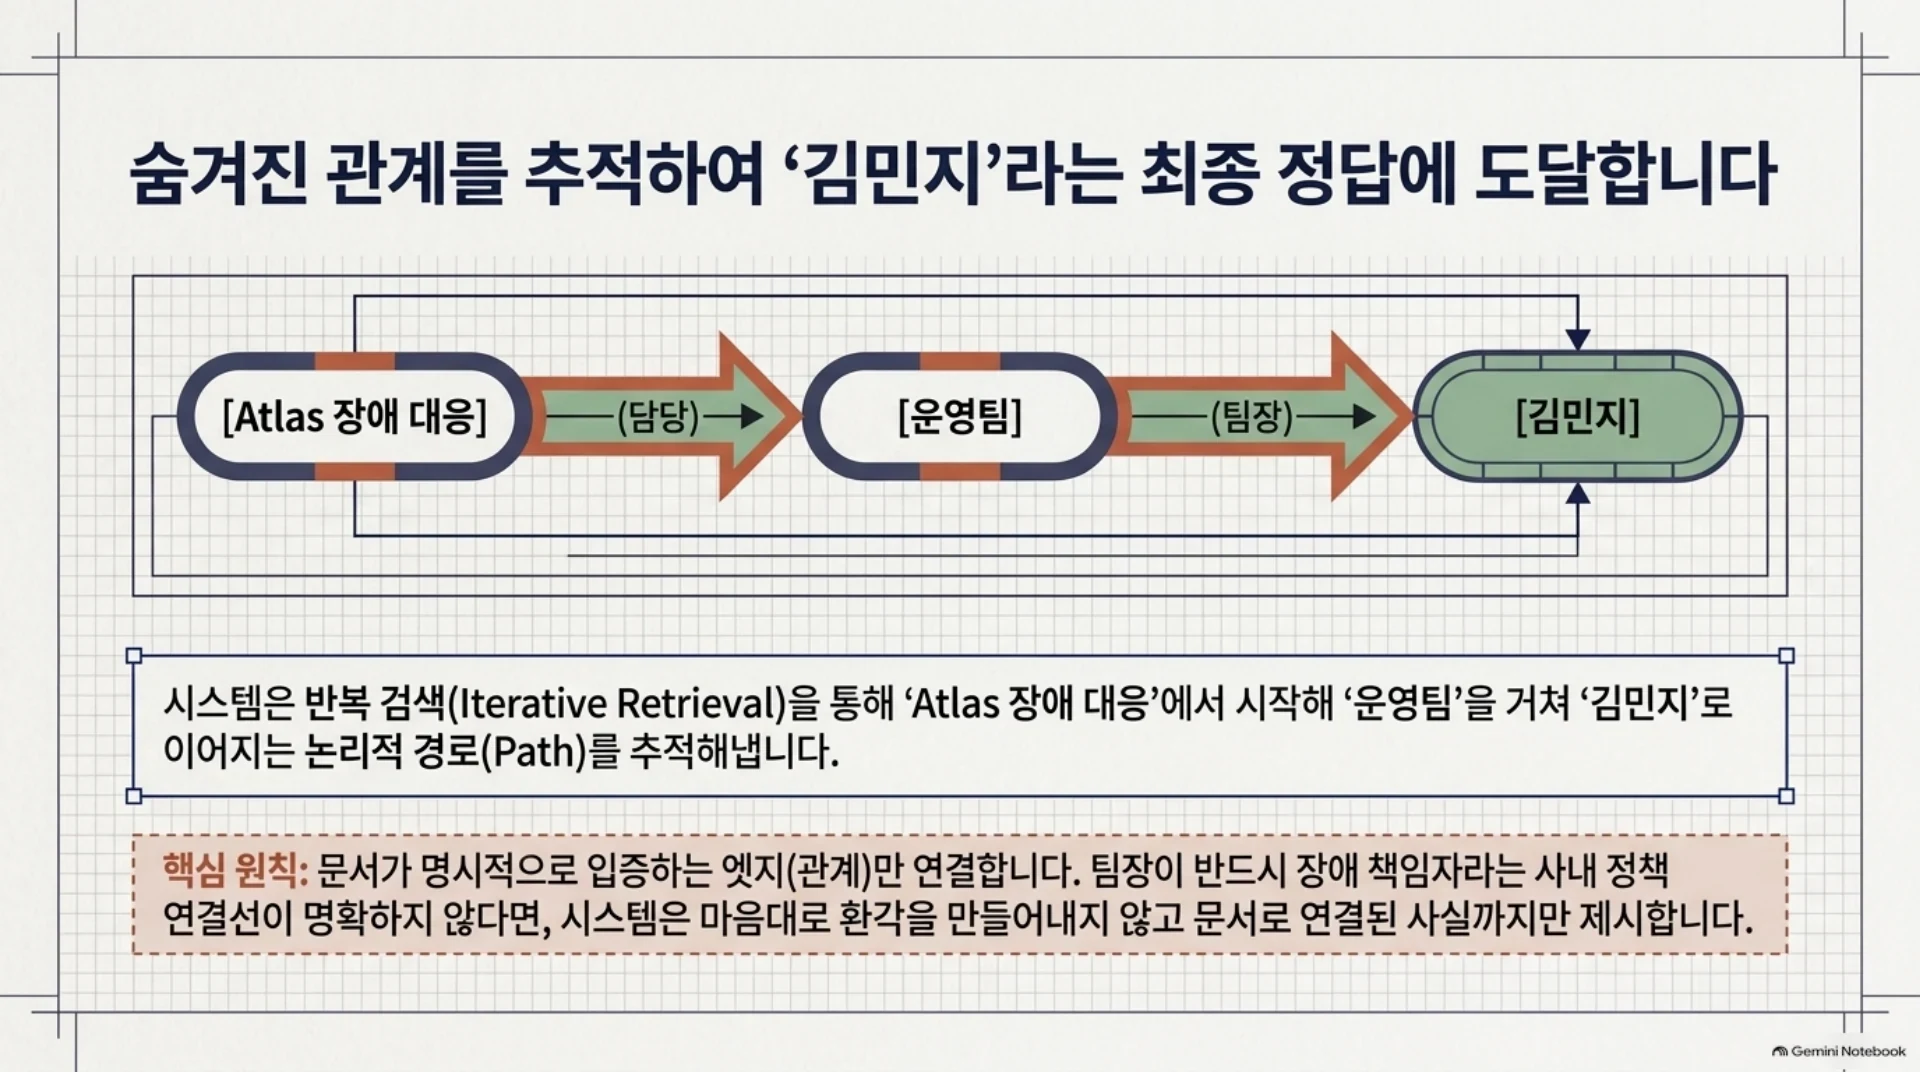
Iterative Retrieval에서는 Atlas의 담당팀을 먼저 찾은 뒤, 그 결과인 운영팀을 시작점으로 팀장을 다시 찾습니다. PullNet은 정해진 횟수만큼 문제 관련 부분 그래프를 확장하는 예이고, KGP는 문맥을 갱신하면서 유사도 기반으로 계속 찾는 예입니다. 멈추는 시점을 고정하지 않는 adaptive retrieval에서는 언어 모델이 몇 hop이 필요한지 예측하거나, 종료 신호와 검색 도구 호출을 이용해 충분한 근거가 모였는지 결정할 수 있습니다.
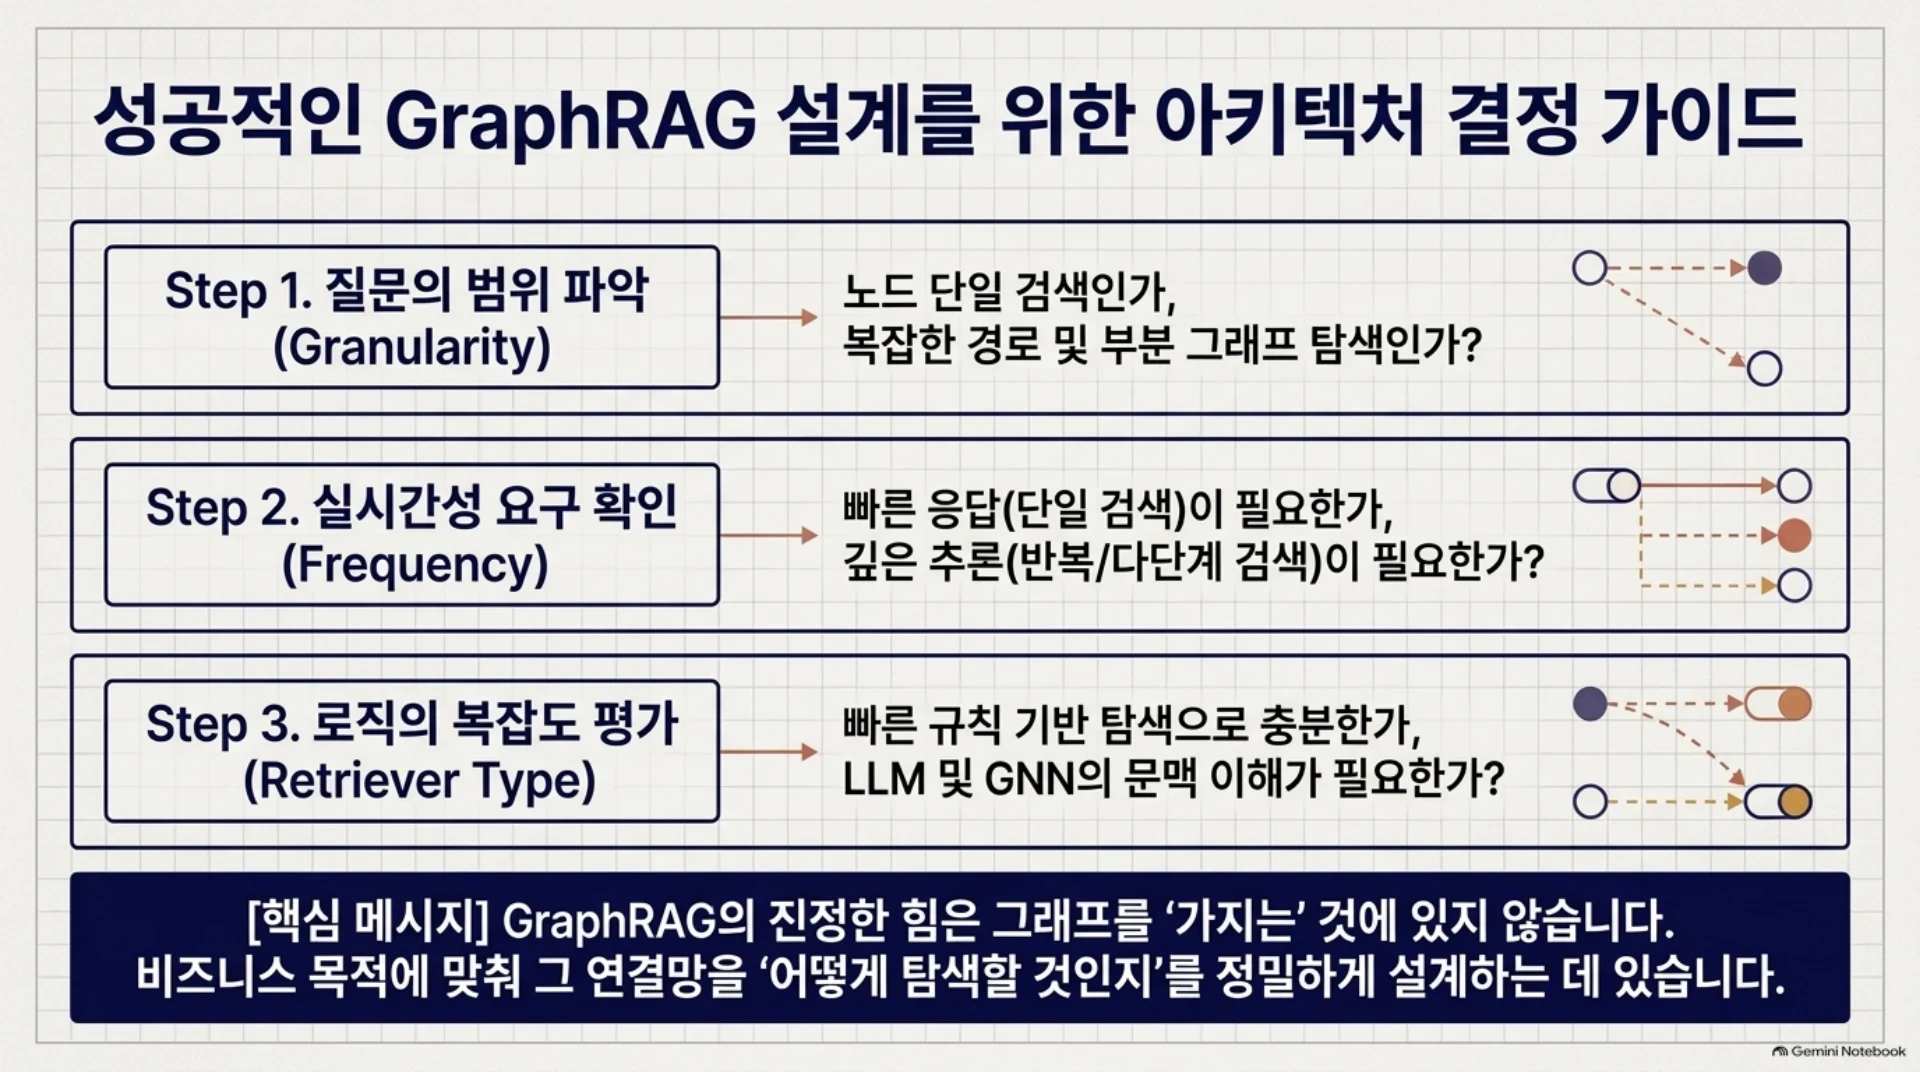
반복 검색은 근거를 차례로 좁힐 수 있지만 호출과 계산이 늘어납니다. 실시간 응답이 중요한 간단한 질문에서는 한 번의 검색이, 연결을 따라가야 하는 질문에서는 반복 검색이 더 알맞을 수 있습니다.
8. 무엇을 검색 결과로 가져올까
Retrieval granularity는 그래프에서 답변기로 넘길 정보의 단위입니다. 같은 질문이어도 어떤 단위를 선택하느냐에 따라 근거의 길이와 설명력이 달라집니다.
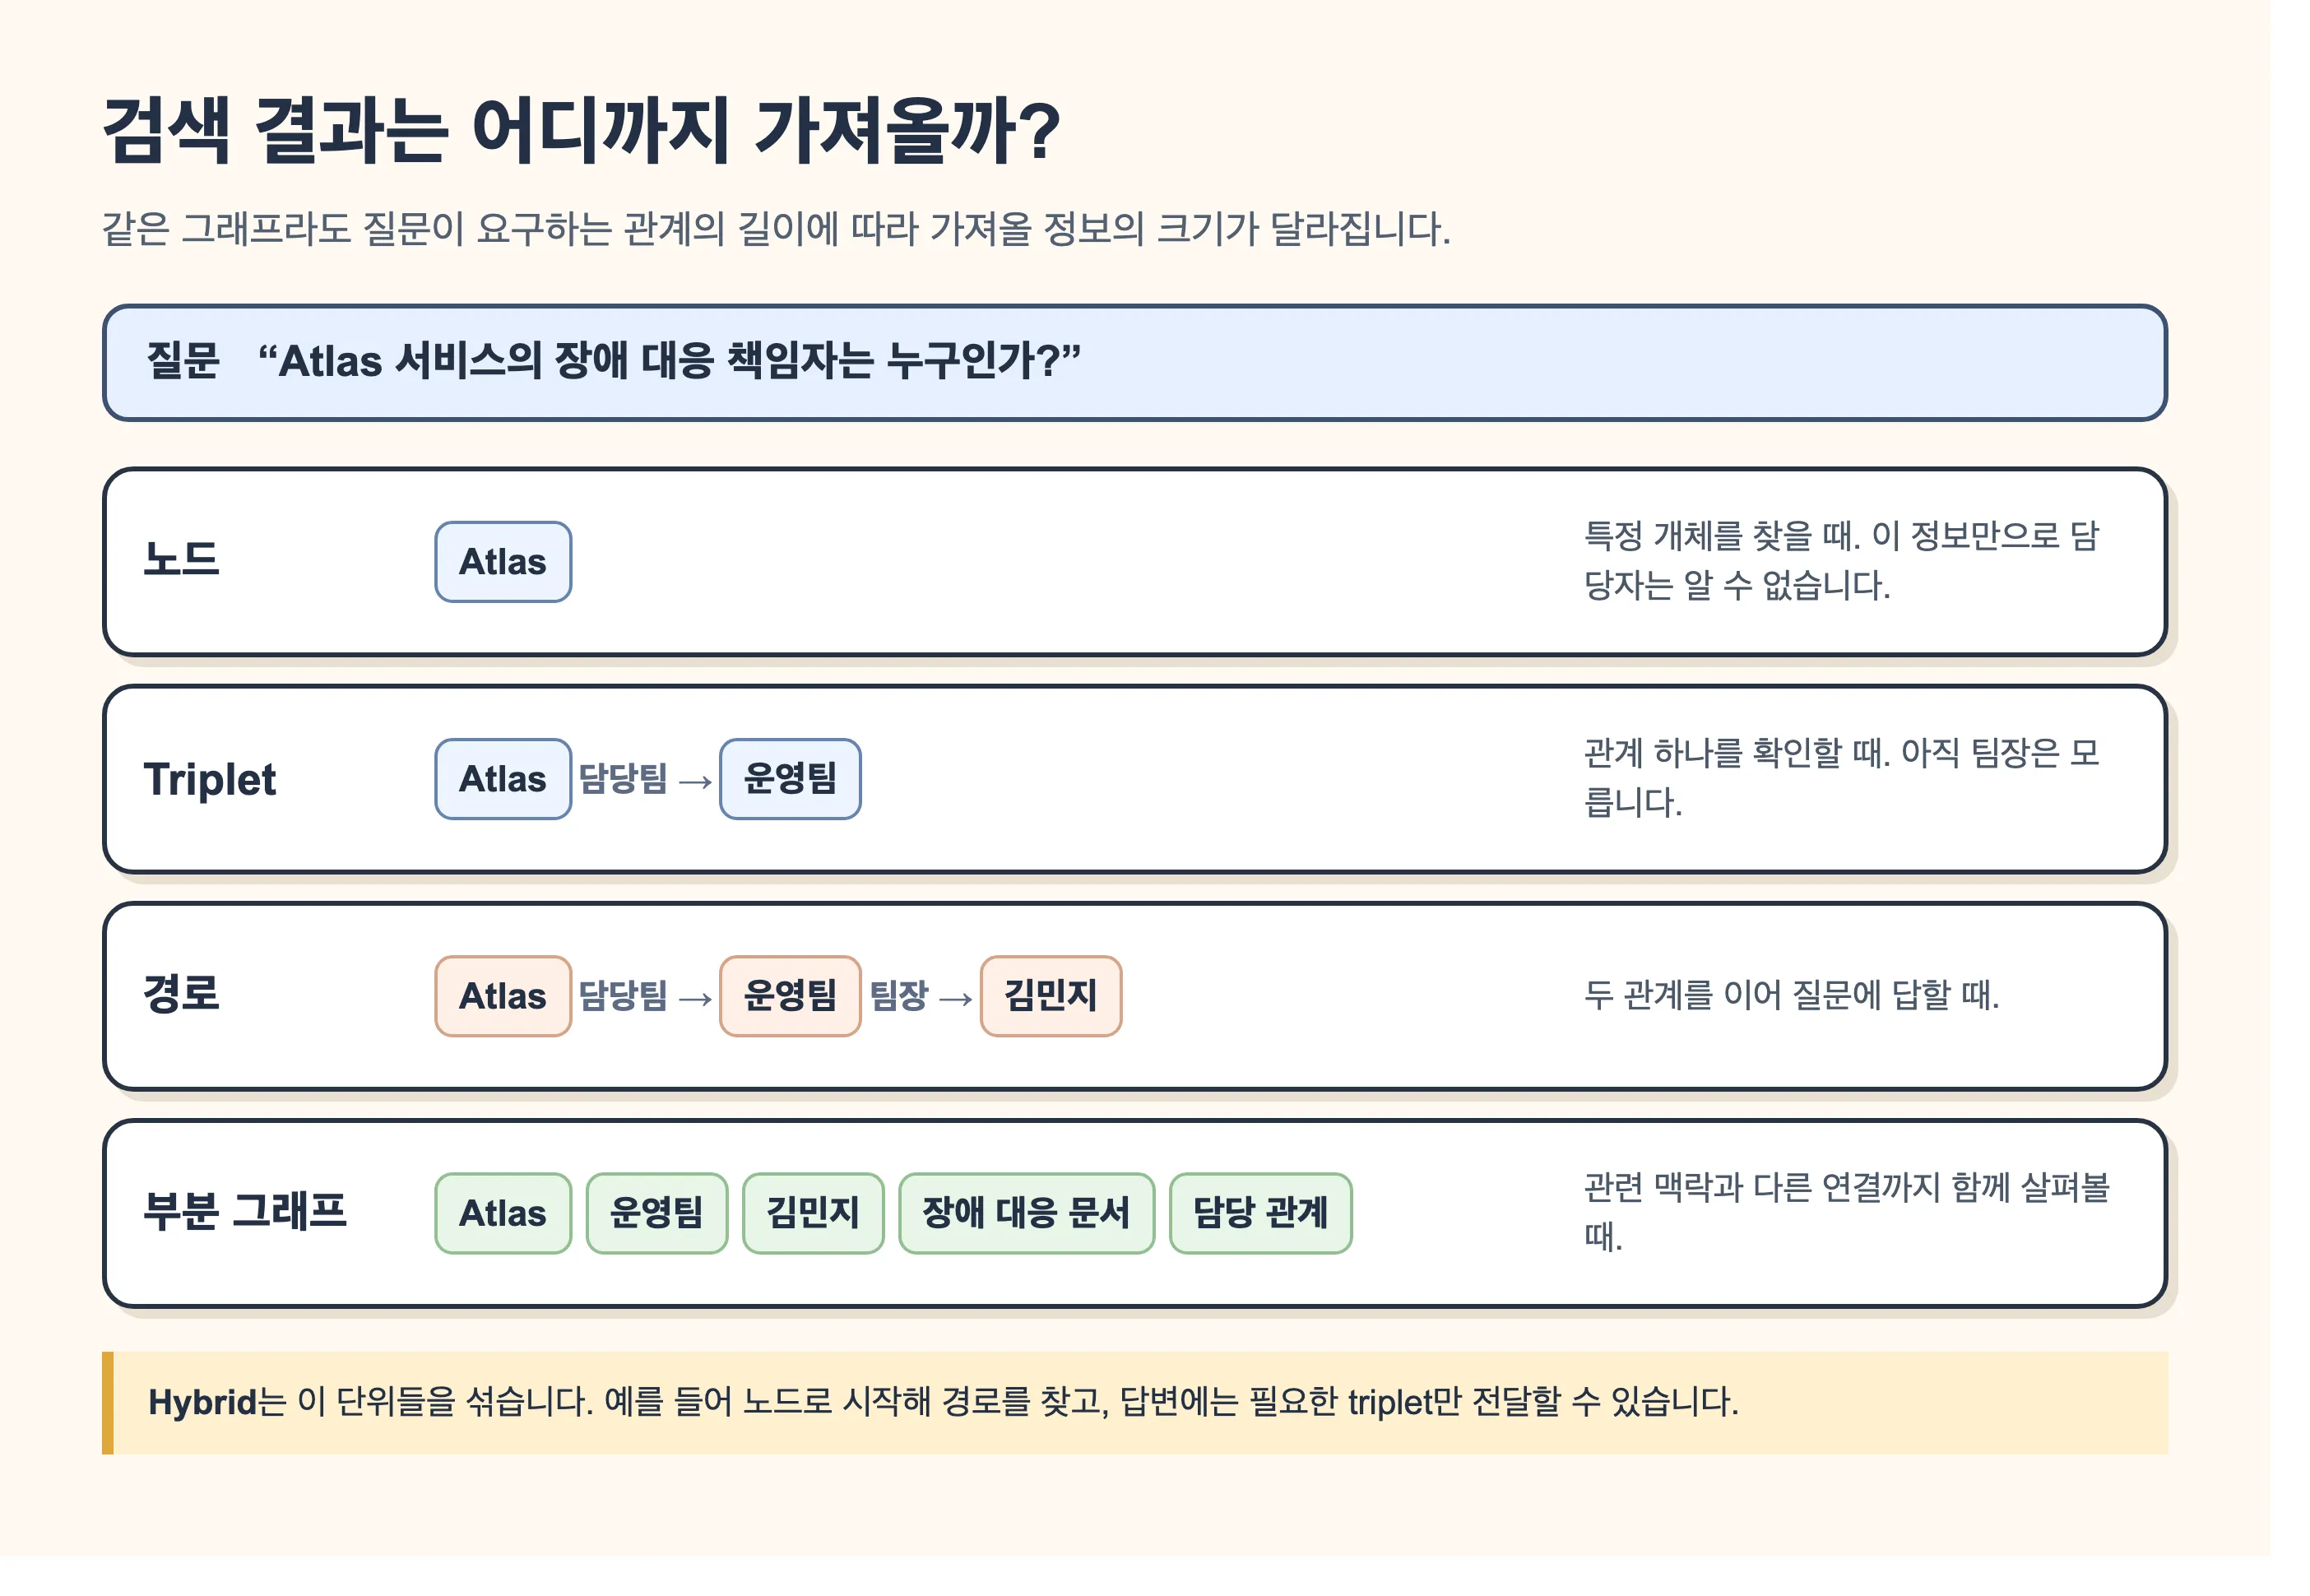
노드는 한 개체나 그 텍스트 속성입니다. Atlas라는 노드나 Wiki의 특정 문단 노드를 찾는 방식입니다. 이름 확인처럼 목표가 좁은 질문에 유용하지만, 관계를 이어야 하는 답에는 부족할 수 있습니다.
Triplet은 주어 ─관계→ 목적어 하나입니다. Atlas ─담당팀→ 운영팀은 담당팀을 알려 주지만 팀장이 누구인지는 알려 주지 않습니다. 주제 개체를 포함하는 triplet을 검색하거나, triplet을 문장으로 바꿔 텍스트 검색할 수 있습니다. 여러 triplet을 논리적으로 이어 찾는 방식도 있습니다.
경로는 triplet이 이어진 순서입니다. Atlas → 운영팀 → 김민지처럼 중간 개체를 거쳐야 하는 질문에 맞습니다. 정해진 hop 안에서 경로를 탐색할 수 있습니다. HyKGE는 경로와 공통 조상, 공동 출현 연결을 활용하는 예이고, ToG는 beam search로 추론 경로를 찾는 예입니다. GNN-RAG도 길이 등의 조건을 만족하는 경로를 추출하는 사례로 등장합니다.
부분 그래프는 경로 하나보다 넓은 주변 관계를 포함합니다. 두 hop 이웃을 모으거나, 특정 노드를 중심으로 한 k-hop ego network를 인코딩하거나, 규칙에 맞는 증거 그래프를 만들 수 있습니다. 여러 경로를 합쳐 부분 그래프를 구성할 수도 있습니다. 맥락은 넓어지지만 답과 관계없는 가지까지 함께 들어오지 않도록 조절해야 합니다.
Hybrid granularity는 질문에 따라 단위를 섞습니다. LLM agent가 노드, triplet, 경로, 부분 그래프 중 무엇을 검색할지 고르게 할 수도 있습니다. 이 단위들은 별개의 세계가 아닙니다. 경로는 triplet들의 연결이고, 부분 그래프는 여러 경로를 포함할 수 있습니다.
9. Wiki 질문을 처음부터 끝까지 처리해 보기
가상의 Wiki에 다음 사실이 흩어져 있다고 가정하겠습니다.
서비스 문서: Atlas의 운영 담당팀은 운영팀이다.
조직 문서: 운영팀의 팀장은 김민지다.
장애 문서: Atlas 장애 대응은 운영 담당팀이 맡는다.
그래프를 만드는 단계에서는 Atlas ─운영 담당팀→ 운영팀, 운영팀 ─팀장→ 김민지, Atlas 장애 대응 ─담당→ 운영팀 같은 관계를 저장합니다. 텍스트와 그래프 인덱스를 함께 만들면 “책임자”처럼 문서의 표현과 다른 질문에도 후보를 찾을 수 있습니다.
사용자가 “Atlas 서비스의 장애 대응 책임자는 누구인가?”라고 물으면 검색기는 Atlas와 장애 대응에 관련된 노드에서 시작합니다. 운영팀까지의 관계를 찾고, 질문이 사람 이름을 요구하므로 운영팀 → 팀장 → 김민지까지 이어 봅니다. 검색 결과에는 문서가 실제로 뒷받침하는 관계만 남겨 답변기에 전달해야 합니다.
답변은 “Atlas의 장애 대응은 운영팀이 맡고, 운영팀의 팀장은 김민지입니다”처럼 관계를 드러내면 됩니다. 단, 조직 문서의 팀장이 실제 장애 상황의 최종 책임자와 같은 뜻인지는 별도 정책이 정할 수 있습니다. 그 연결을 입증하는 문서가 없다면 팀장을 곧바로 최종 책임자라고 단정하지 않는 것이 정확합니다.
GraphRAG를 설계할 때는 먼저 질문이 요구하는 관계의 길이를 보세요. 개체 하나면 노드, 관계 하나면 triplet, 여러 관계를 이어야 하면 경로, 주변 맥락까지 확인해야 하면 부분 그래프가 출발점입니다. 그런 다음 응답 시간과 검색 정확도에 맞춰 규칙, LM, GNN, 반복 검색을 선택하면 됩니다.