2분
밤새 실험하는 AI 연구원, 카파시의 autoresearch
에이전트가 train.py를 고치고 5분간 학습한 뒤 val_bpb로 결과를 골라내는 autoresearch의 구조, 성과와 한계를 설명합니다.
autoresearch는 AI 에이전트가 작은 LLM의 학습 코드를 직접 바꾸고, 같은 조건에서 결과를 비교하며 다음 실험을 스스로 고르는 프로젝트입니다.
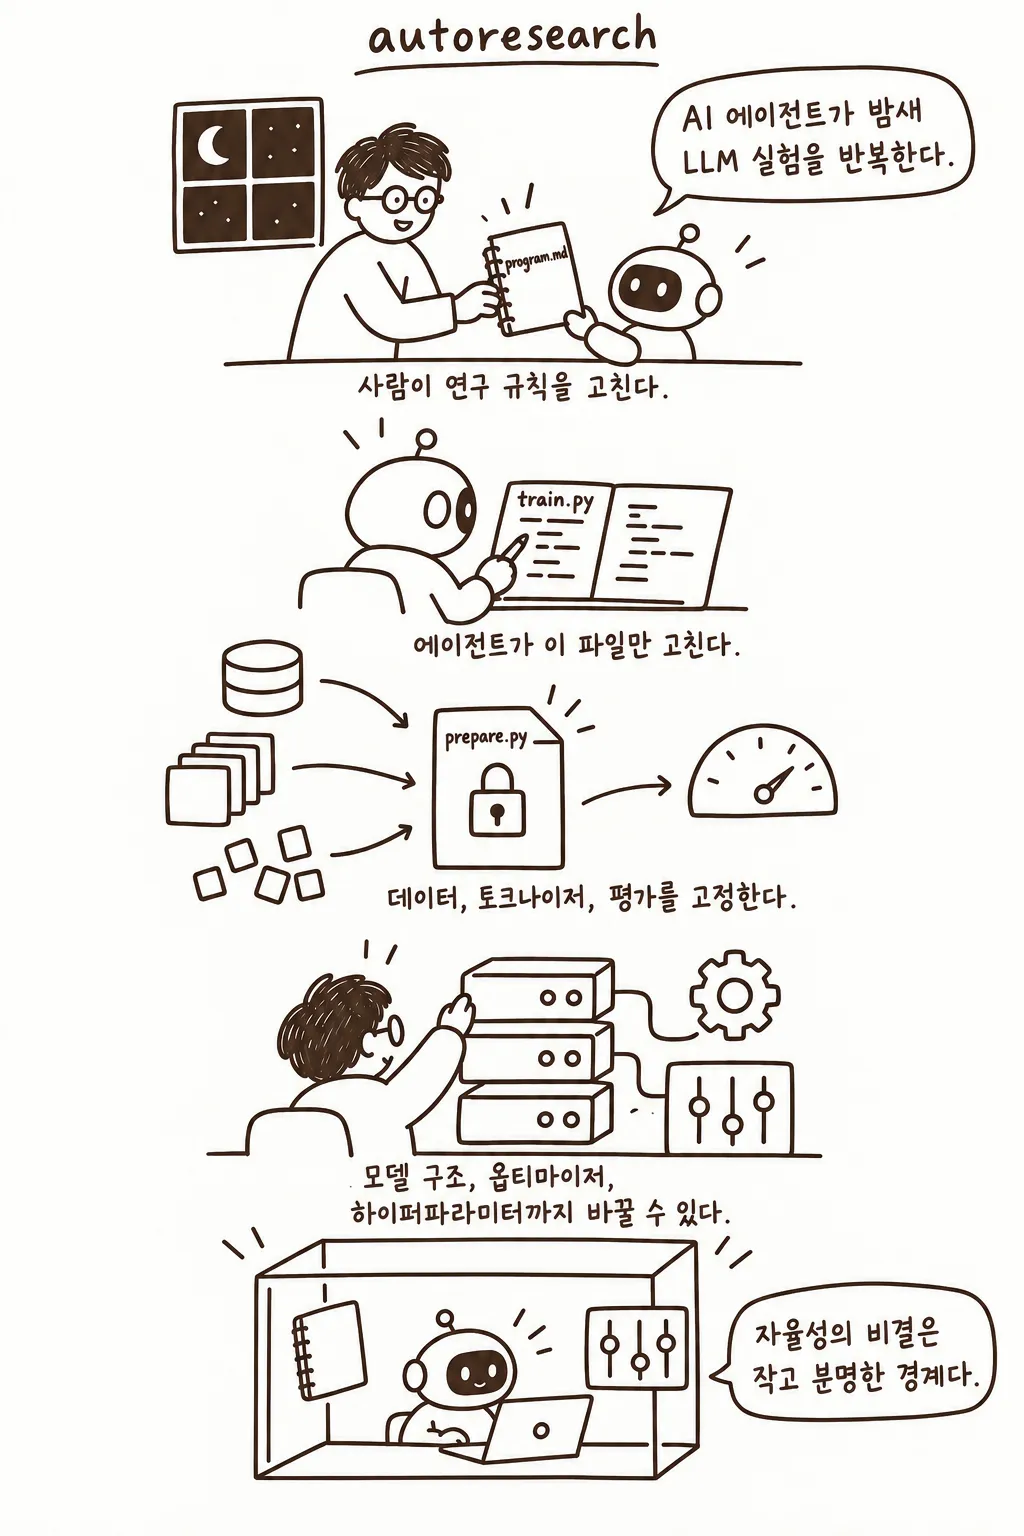
먼저 사람, 에이전트, 평가 환경의 책임을 세 파일로 분리합니다.
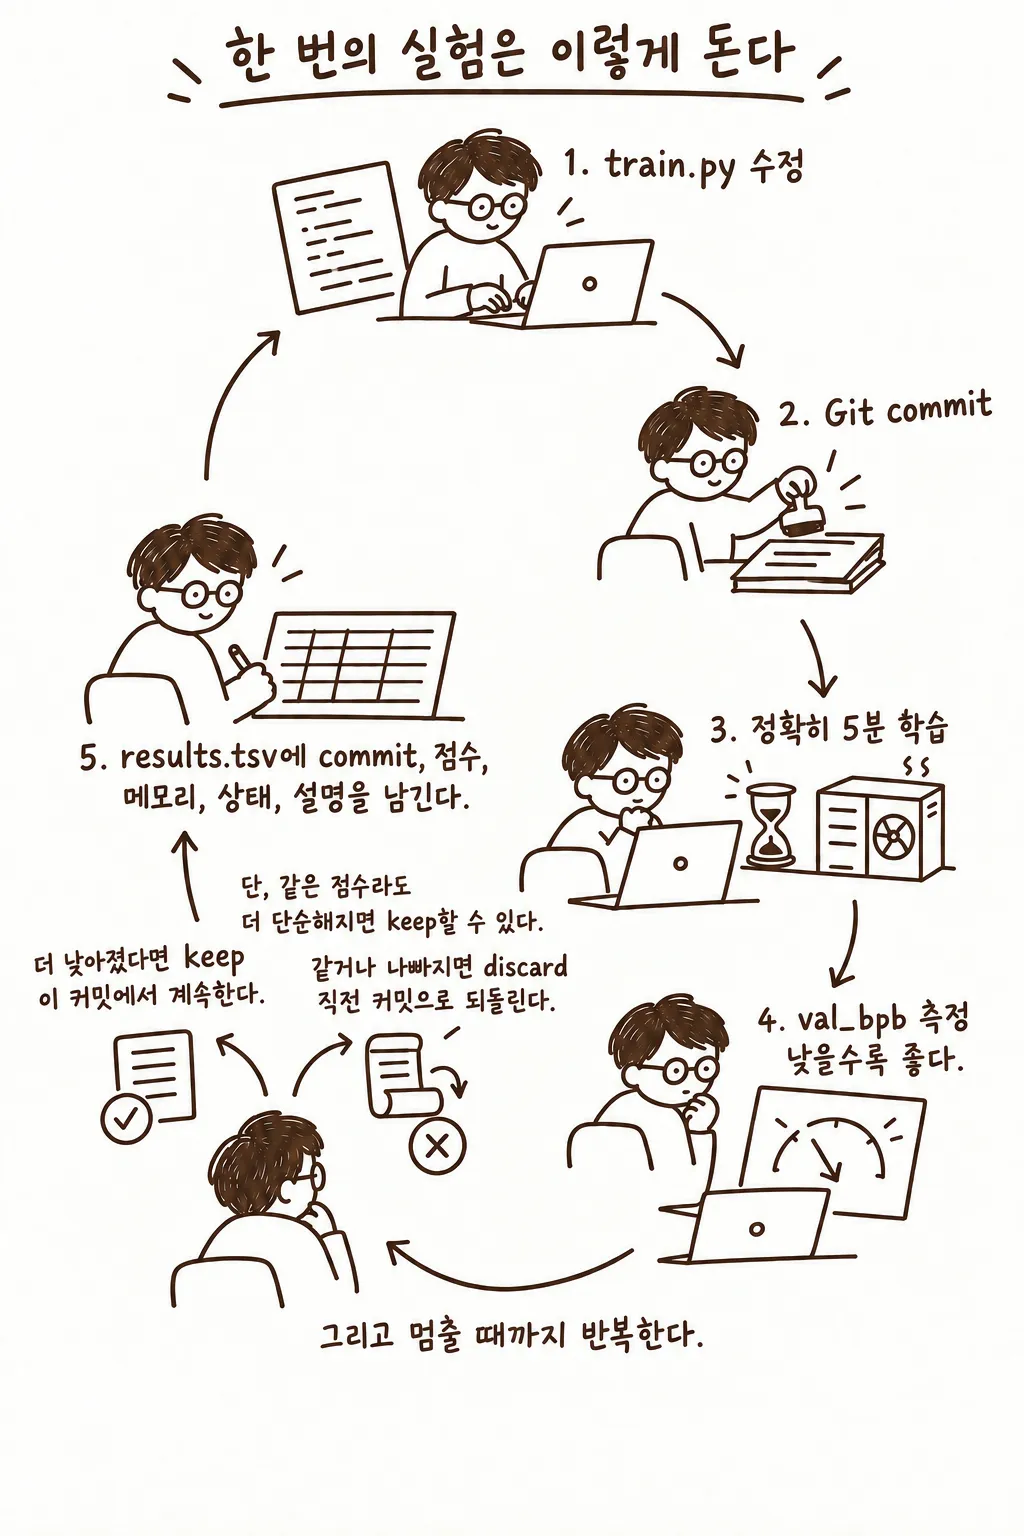
그 경계 안에서 한 번에 하나씩 바꾸고, 같은 시간과 지표로 실험을 골라냅니다.
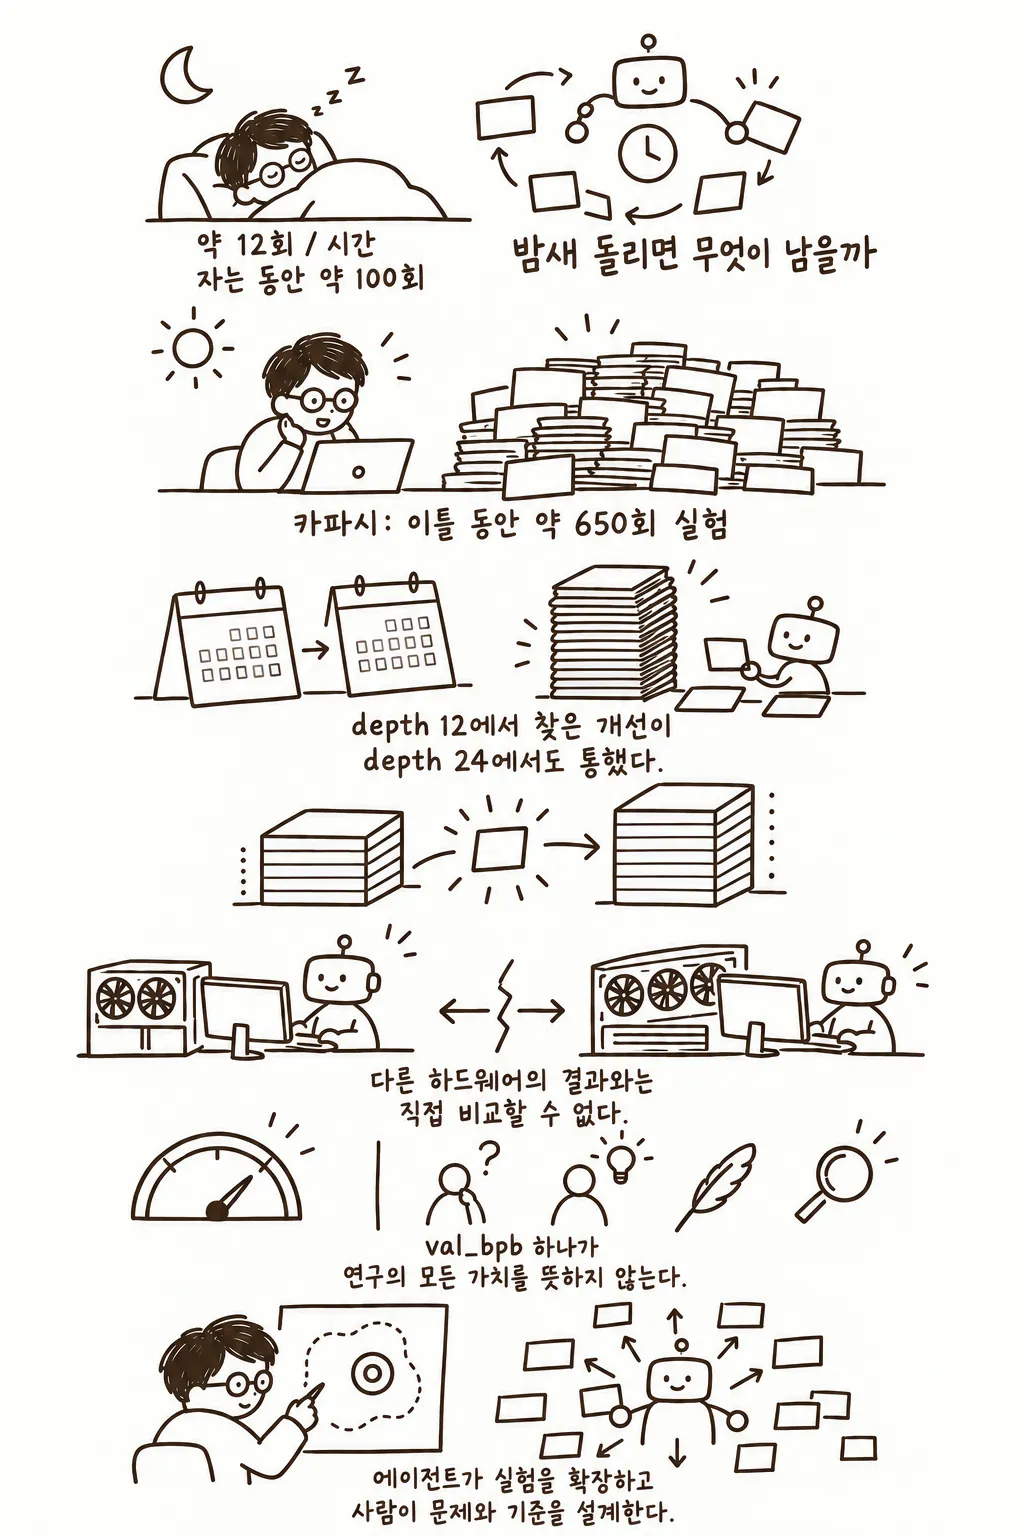
val_bpb는 validation bits per byte, 즉 검증 데이터의 바이트당 비트 수입니다. 낮을수록 예측이 좋고 어휘 크기에 좌우되지 않아 서로 다른 구조를 비교하기에 알맞습니다.
카파시는 이 구조로 이틀 동안 약 650번 실험해 작은 모델에서 찾은 개선이 더 큰 모델에도 옮겨간다고 보고했습니다. 하지만 한 GPU에서 5분 안에 가장 낮은 val_bpb를 찾는 일은 연구의 모든 판단을 대신하지 않습니다. 무엇을 바꿀지, 무엇을 고정할지, 어떤 결과를 가치 있다고 볼지는 여전히 사람이 설계합니다.