Confluence 위키 QA 에이전트는 어떻게 채점할까
가상 위키와 정답표를 기준으로 문서 검색, 답변의 필수 사실, 근거 충실성, 인용, 답변 보류를 나눠 채점하는 방법을 예시와 계산식으로 설명합니다.
Confluence 위키를 읽고 답하는 에이전트를 만들었다고 해봅시다. 사용자의 질문에 답변이 그럴듯하게 나오더라도 맞는 페이지를 찾았는지, 그 페이지가 실제로 답변을 뒷받침하는지는 별개의 문제입니다. 내부 위키에는 공개 시험처럼 정답이 붙어 있지 않으니 품질을 숫자로 비교하기도 어렵습니다.
가상의 위키에 확인 가능한 사실을 넣고, 질문마다 정답과 근거 페이지를 기록하면 이 문제를 다룰 수 있습니다. 여기서는 위키를 생성하는 절차보다 이미 준비된 가상 위키와 정답표로 무엇을 어떻게 채점할지에 집중합니다.
정답 문장 하나로는 부족하다
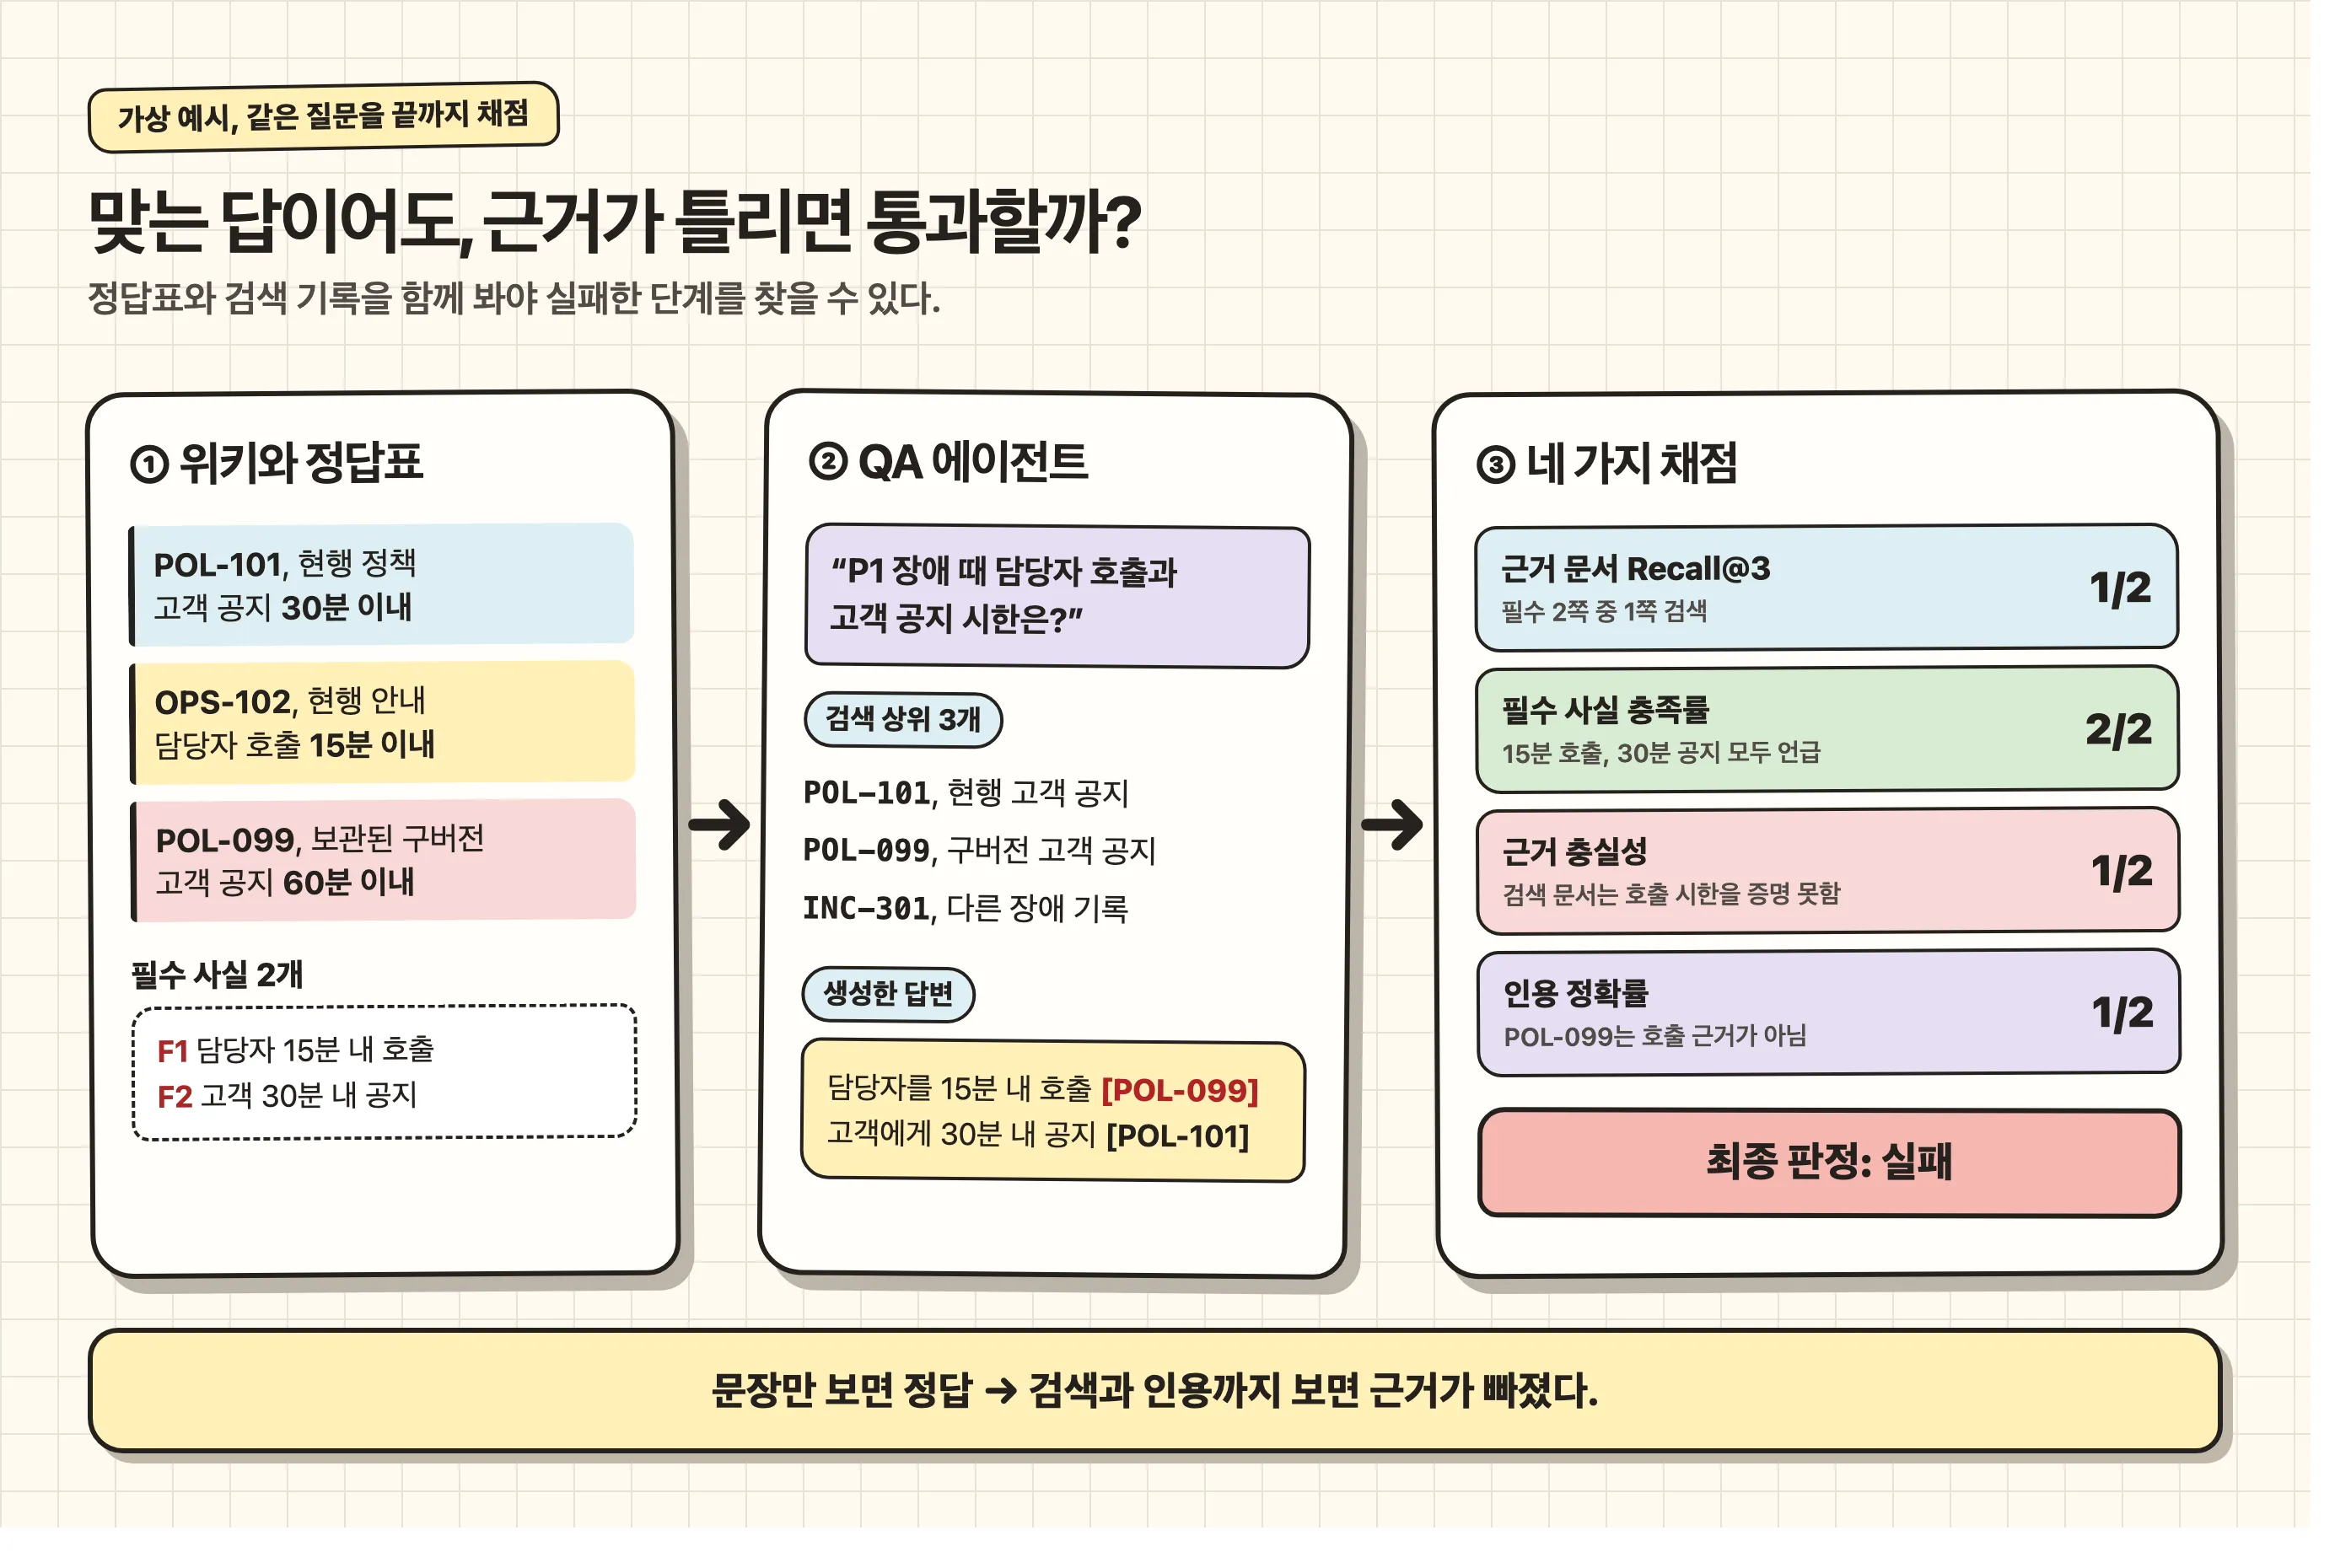
가상의 장애 대응 위키에 세 페이지가 있다고 하겠습니다. 아래 내용과 ID는 채점 방법을 보여 주기 위한 가상 예시입니다.
| 페이지 ID | 상태 | 핵심 내용 |
|---|---|---|
POL-101 | 현행 정책 | P1 장애가 발생하면 고객에게 30분 이내 공지한다. |
OPS-102 | 현행 안내 | P1 장애가 발생하면 담당자를 15분 이내 호출한다. |
POL-099 | 보관된 구버전 | P1 장애의 고객 공지 시한은 60분 이내다. |
질문이 “P1 장애 때 담당자 호출과 고객 공지 시한은?”이라면 정답에는 두 사실이 모두 있어야 합니다. “담당자는 15분 이내 호출, 고객에게는 30분 이내 공지”라는 문장과 “15분 안에 담당자를 부르고 30분 안에 고객에게 알린다”는 문장은 표현은 달라도 같은 답입니다. 반면 “30분 이내 공지”만 말하면 일부만 답한 것입니다.
따라서 골든 세트에는 모범 문장뿐 아니라 검사 가능한 작은 사실, 그 사실을 지지하는 페이지, 질문의 답변 가능 여부를 넣습니다. 예시 JSON은 설명용 형식이며 특정 평가 도구의 필수 스키마는 아닙니다.
{
  "question_id": "Q-001",
  "question": "P1 장애 때 담당자 호출과 고객 공지 시한은?",
  "answerable": true,
  "required_facts": [
    {"id": "F1", "fact": "담당자를 15분 이내 호출", "page_ids": ["OPS-102"]},
    {"id": "F2", "fact": "고객에게 30분 이내 공지", "page_ids": ["POL-101"]}
  ],
  "gold_answer": "담당자는 15분 이내 호출하고 고객에게는 30분 이내 공지한다."
}page_ids에는 그 사실을 실제로 증명하는 페이지를 기록합니다. 같은 사실을 여러 현행 페이지가 증명한다면 허용 가능한 페이지를 모두 넣어야 합니다. 그렇지 않으면 다른 유효한 근거를 찾은 에이전트를 잘못 감점할 수 있습니다. 보관된 POL-099는 검색 방해 문서이지 F2의 올바른 근거가 아닙니다.
EnterpriseRAG-Bench는 비슷하게 질문별 gold_answer, 원자적 사실 목록인 answer_facts, 근거 문서 ID인 expected_doc_ids를 제공합니다. 공개 벤치마크를 참고할 수 있지만, 아래 채점 기준은 Confluence 위키 에이전트에 맞춰 제안하는 방식입니다.
1. 검색: 필요한 페이지를 찾았는가
먼저 에이전트가 답변을 만들기 전에 찾은 페이지 ID를 기록합니다. 위 질문의 필수 근거는 OPS-102, POL-101 두 페이지입니다. 검색 결과 상위 3개가 POL-101, POL-099, INC-301이라면 필요한 페이지 하나만 찾았습니다.
근거 문서 Recall@3
= 상위 3개 검색 결과에 포함된 필수 근거 페이지 수 / 필수 근거 페이지 수
= 1 / 2 = 0.5
검색 결과를 청크로 저장한다면 먼저 각 청크를 원본 Confluence 페이지 ID와 버전에 연결한 뒤 계산합니다. 같은 페이지의 청크 세 개를 찾았다고 근거 페이지 세 개를 찾은 것은 아닙니다. 현행 문서와 보관된 구버전도 구분해야 합니다.
이 수치는 검색 진단 지표입니다. 정답에 필요한 페이지를 못 찾았는데도 최종 문장이 맞았다면, 에이전트가 위키에 근거해 답했다고 보기 어렵습니다. 반대로 검색은 성공했는데 답변이 틀렸다면 생성 또는 근거 해석 단계의 문제입니다. EnterpriseRAG-Bench도 근거 문서 검색률을 답변 정확성과 분리해 보고합니다. 평가 방법
2. 답변: 필수 사실을 빠짐없이 전달했는가
표현을 글자 그대로 비교하면 “15분 이내”와 “15분 안에”를 다른 답으로 처리합니다. 여기서는 LLM 평가자에게 질문, required_facts, 후보 답변을 주고 사실별로 담겼는지 판정하게 합니다.
필수 사실 충족률 = 답변에 담긴 필수 사실 수 / 전체 필수 사실 수예를 들어 “담당자는 15분 이내 호출합니다”만 답했다면 F1은 통과, F2는 누락이므로 1/2 = 0.5입니다. “15분 이내 호출하고 60분 이내 공지”라면 F1은 맞지만 F2의 수치가 틀립니다. 날짜, 시간, 금액, 버전처럼 정확한 값은 LLM의 의미 판정 결과와 별도로 값도 확인합니다.
답변에 필수 사실이 다 있더라도 추가로 틀린 주장을 했다면 정답으로 처리하지 않습니다. 예를 들어 “30분 이내 공지하며, 모든 P1 사고는 자동으로 환불됩니다”에서 환불 규정이 위키에 없다면 두 번째 주장은 근거 없는 추가 정보입니다. Ragas의 Faithfulness는 답변의 주장을 나눠 검색된 문맥이 뒷받침하는 주장의 비율을 측정합니다.
근거 충실성 = 검색된 문서가 지지하는 답변 주장 수 / 답변의 전체 사실 주장 수필수 사실 충족률은 빠진 내용을, 근거 충실성은 문서 밖에서 덧붙인 내용을 잡습니다. 둘 중 하나만 보면 답변의 문제를 놓칠 수 있습니다.
3. 인용: 맞는 문장을 엉뚱한 페이지에 달지 않았는가
앞의 검색 결과에는 OPS-102가 없었습니다. 그런데 에이전트가 이렇게 답했다고 해봅시다.
담당자를 15분 이내 호출합니다 [
POL-099]. 고객에게는 30분 이내 공지합니다 [POL-101].
정답 문장만 읽으면 두 사실이 모두 맞습니다. 하지만 첫 번째 인용은 담당자 호출과 관계없는 보관된 고객 공지 페이지입니다. 주장별로 인용한 페이지가 그 주장을 실제로 지지하는지 다시 검사해야 합니다.
인용 정확률 = 올바른 페이지가 뒷받침하는 인용된 주장 수 / 인용된 전체 주장 수
          = 1 / 2 = 0.5
문서 ID가 존재하는지는 코드로 확인할 수 있습니다. 문서 내용이 주장을 뒷받침하는지는 해당 페이지의 관련 부분만 보여 주고 LLM 평가자로 판정할 수 있습니다. 가능하면 평가자는 주장별 판정, 지지한 문장 위치, 불일치 이유를 구조화해 반환하도록 합니다. “페이지가 검색 결과에 있었다”와 “그 페이지를 올바르게 인용했다”는 다릅니다.
이는 공개 벤치마크를 그대로 사용할 때 특히 주의할 점입니다. EnterpriseRAG-Bench는 답변 정확성을 판정하기 전에 인용 표시를 제거하므로 인용의 적절성은 그 점수에 반영되지 않습니다. 채점 절차
한 질문의 결과를 끝까지 계산해 보기
앞의 답변을 채점하면 다음과 같습니다.
| 항목 | 결과 | 이유 |
|---|---|---|
| 근거 문서 Recall@3 | 0.5 | 필수 페이지 2개 중 POL-101만 검색 |
| 필수 사실 충족률 | 1.0 | 15분 호출, 30분 공지를 모두 말함 |
| 검색 문서 기준 근거 충실성 | 0.5 | 공지는 검색된 현행 문서가 지지하지만 호출은 지지하지 않음 |
| 인용 정확률 | 0.5 | 두 인용 중 POL-101만 해당 주장을 지지 |
| 최종 판정 | 실패 | 맞는 답을 썼지만 호출 근거를 읽거나 올바르게 인용하지 못함 |
답변 가능한 질문은 세 조건을 모두 만족해야 통과로 판정합니다: 필수 사실 전부 포함, 틀리거나 근거 없는 핵심 주장 없음, 핵심 주장마다 유효한 인용 있음. 검색률, 사실 충족률, 인용 정확률은 한 숫자로 평균 내기보다 함께 보여 주어 실패 위치를 드러냅니다. 인용 자체가 필수인 제품을 가정한 기준이며, 제품의 답변 형식에 따라 인용 요구는 명시적으로 조정해야 합니다.
참고로 EnterpriseRAG-Bench의 대표 종합 점수는 각 질문의 정확성(0 또는 1) × 완전성(0~1)을 평균한 값입니다. 그 벤치마크의 점수식과 위에서 제안한 인용 포함 통과 기준은 서로 다릅니다. 공개 점수식
답이 없는 질문도 채점한다
“P1 장애의 일본어 공지는 어느 팀이 맡나요?”라는 질문에 위키 어디에도 담당 팀이 없다고 합시다. 이 문제의 answerable은 false입니다. “위키에서 담당 팀을 확인할 수 없습니다”는 통과하고, 그럴듯한 팀 이름을 지어내면 실패입니다. 반대로 위키에 답이 있는데도 “확인할 수 없습니다”라고만 하면 잘못된 답변 보류입니다.
답 없음 문제는 전체 위키 스냅샷을 기준으로 실제로 답이 없는지 검수해야 합니다. 특정 페이지 하나에 답이 없다는 이유만으로 answerable: false를 붙이면 골든 세트 자체가 틀릴 수 있습니다. 평가 결과에는 답 없음 질문의 올바른 보류율과 답이 있는 질문의 잘못된 보류율을 따로 표시합니다. EnterpriseRAG-Bench 역시 정보가 없는 질문을 별도 유형으로 포함합니다. 질문 유형
LLM 평가자를 어떻게 믿을까
LLM은 동의어와 문맥을 비교하는 데 유용하지만, 평가자가 만든 숫자 하나를 그대로 진실로 취급하면 안 됩니다. LLM 평가에는 표현이나 평가 기준에 따른 편향이 보고되어 있습니다. LLM 평가자 편향 연구
실무에서는 역할을 나누는 편이 명확합니다. 문서 ID, 현행 버전, 검색 순위와 점수 계산은 코드로 검사합니다. 표현이 다른 두 답의 의미, 문서가 실제로 주장을 지지하는지, 인용이 해당 주장에 맞는지는 LLM 평가자가 판정합니다. 골든 사실의 오류나 애매한 질문, 사람과 평가자의 판정이 어긋난 사례는 사람이 검수합니다.
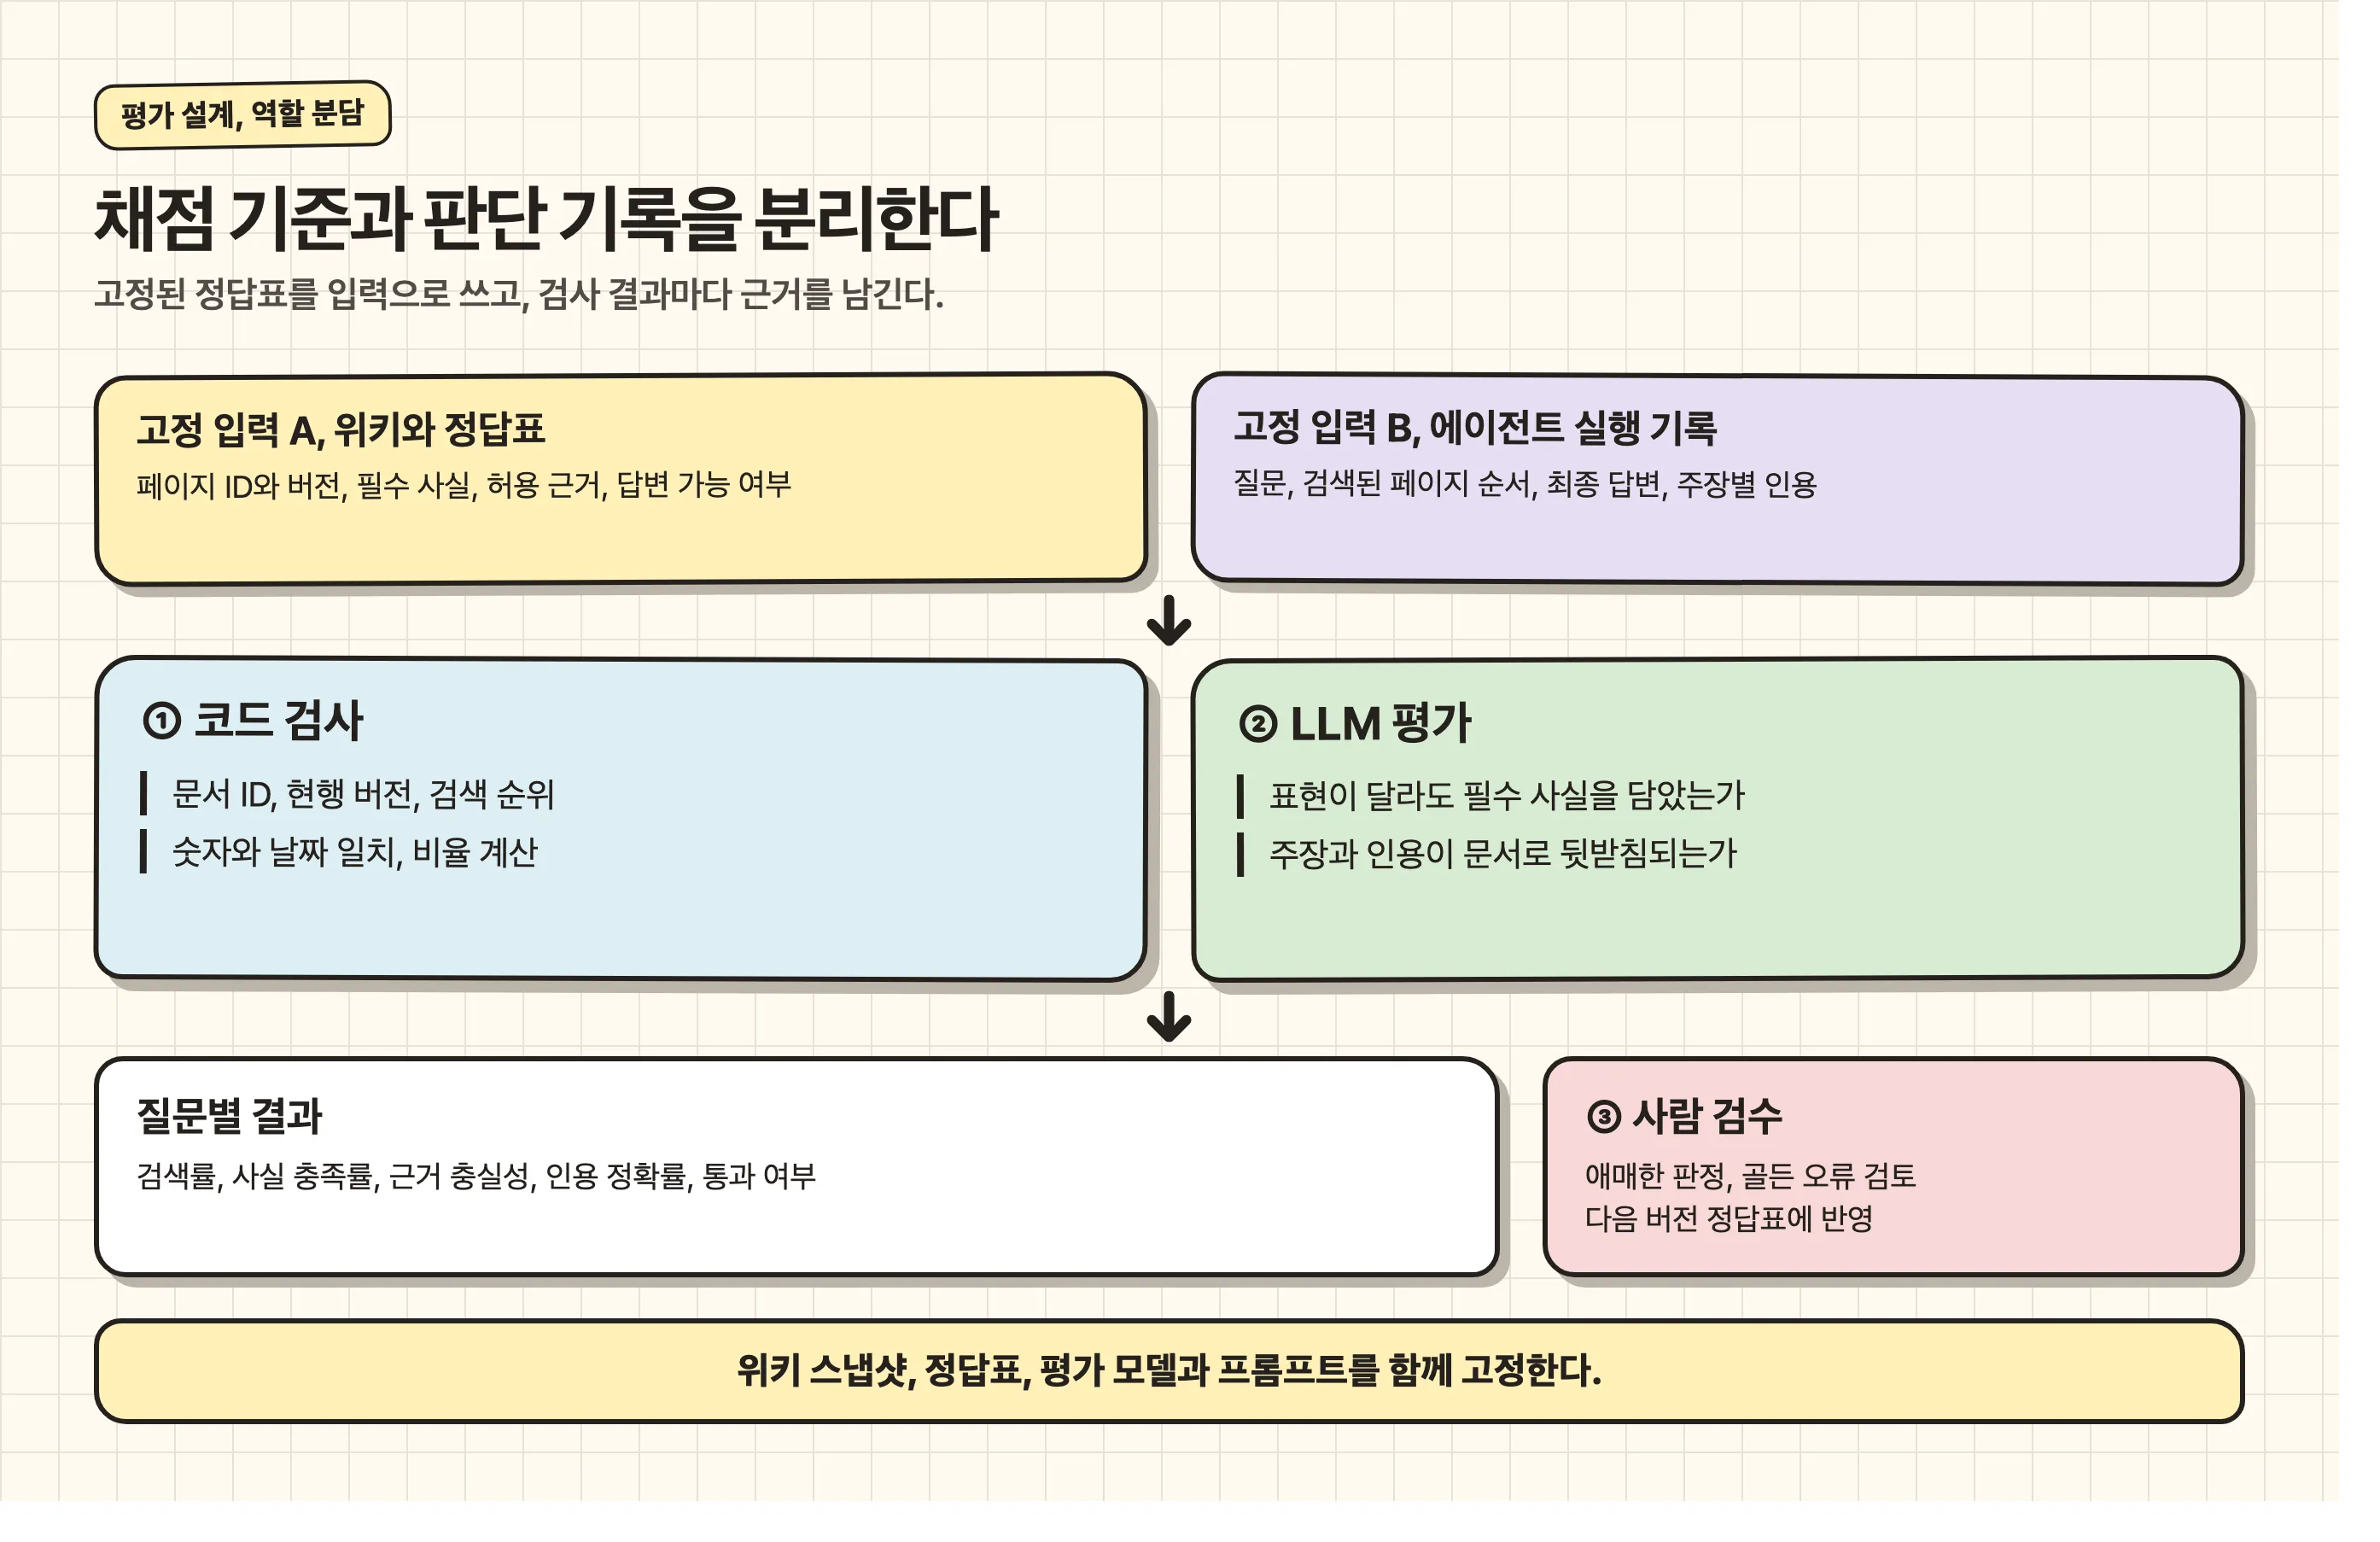
LLM 평가자에게는 평가 대상 모델의 이름을 숨기고, 위키의 해당 스냅샷과 정답표에만 근거해 통과/실패, 이유, 근거 위치를 구조화해 내게 합니다. 평가 모델, 프롬프트, 위키 스냅샷, 골든 세트 버전은 함께 기록해야 다음 실행과 비교할 수 있습니다. 사람이 판정한 표본으로 평가자의 오판을 먼저 점검하고, 애매한 결과는 재검토합니다.
가상 위키는 회귀 테스트에 특히 유용하지만 실제 사용자의 질문 방식까지 대표하지는 않습니다. 한 연구에서는 합성 질문이 실제 질문보다 길고 문서 전반에 고르게 퍼져 있어 평가 결과가 달라질 수 있음을 보였습니다. 따라서 위키 기반 골든 세트의 점수와 익명화해 검수한 실제 사용자 질문의 점수를 별도로 봐야 합니다. 합성 질문과 실제 질문 비교 연구
무엇을 보면 고칠 곳이 보이나
평가 결과는 총점 하나보다 질문 유형과 실패 단계별 표가 유용합니다. 단일 페이지, 여러 페이지 종합, 구버전과 충돌, 답 없음 질문을 나눠 봅니다. 검색률이 낮으면 수집, 청킹, 검색을 점검하고, 검색률은 높은데 필수 사실이 빠지면 답변 생성 단계를 점검합니다. 답은 맞는데 인용 정확률이 낮으면 페이지와 주장 사이의 연결을 고쳐야 합니다.
가상 위키의 정답표는 평가 실행 중 자동으로 바꾸지 않고 버전을 고정합니다. 다른 유효한 근거가 발견되면 먼저 사람이 확인하고 다음 버전에 반영합니다. 그래야 지난주와 이번 주의 점수가 같은 시험지를 기준으로 비교됩니다.