2분
만드는 에이전트와 평가하는 에이전트를 왜 분리해야 하나
자기평가의 함정을 피하기 위한 Planner, Generator, Evaluator 구조와 스프린트 계약, 실제 검증 루프, 비용의 경계를 설명합니다.
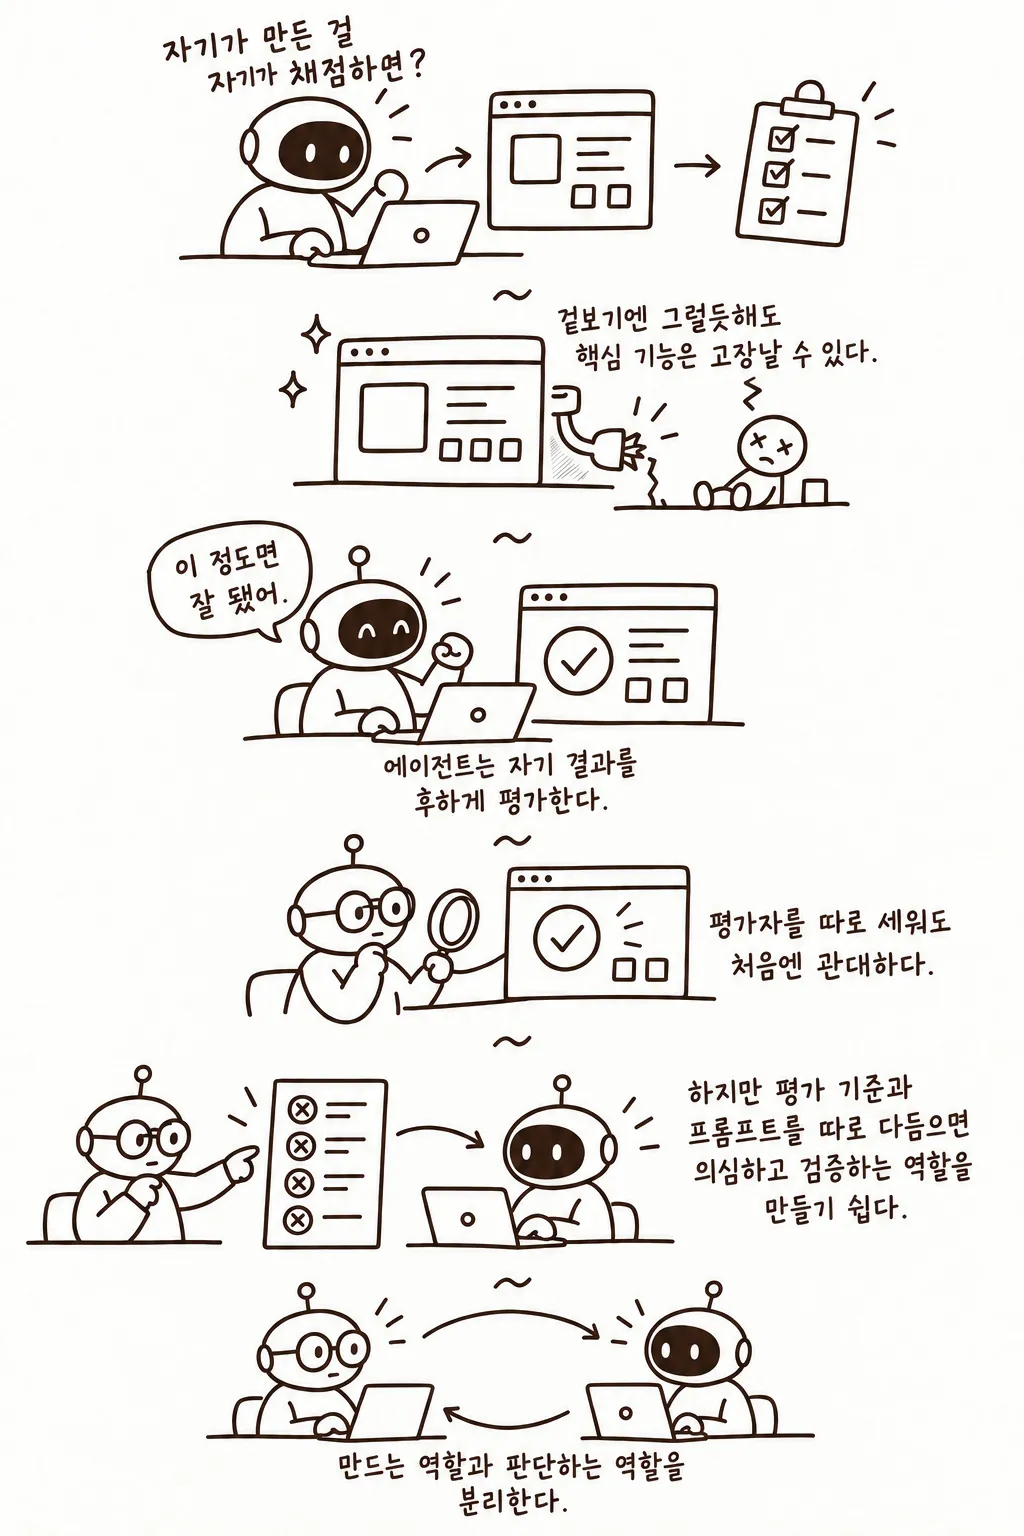
Anthropic은 만든 에이전트에게 자기 결과를 평가시키면 눈에 띄는 결함이 있어도 자신 있게 칭찬하는 경향을 관찰했습니다. 별도 Evaluator도 처음부터 엄격하지는 않았지만, 평가 기준과 프롬프트를 독립적으로 다듬자 Generator가 반복해서 수정할 수 있는 구체적인 피드백을 만들 수 있었습니다.
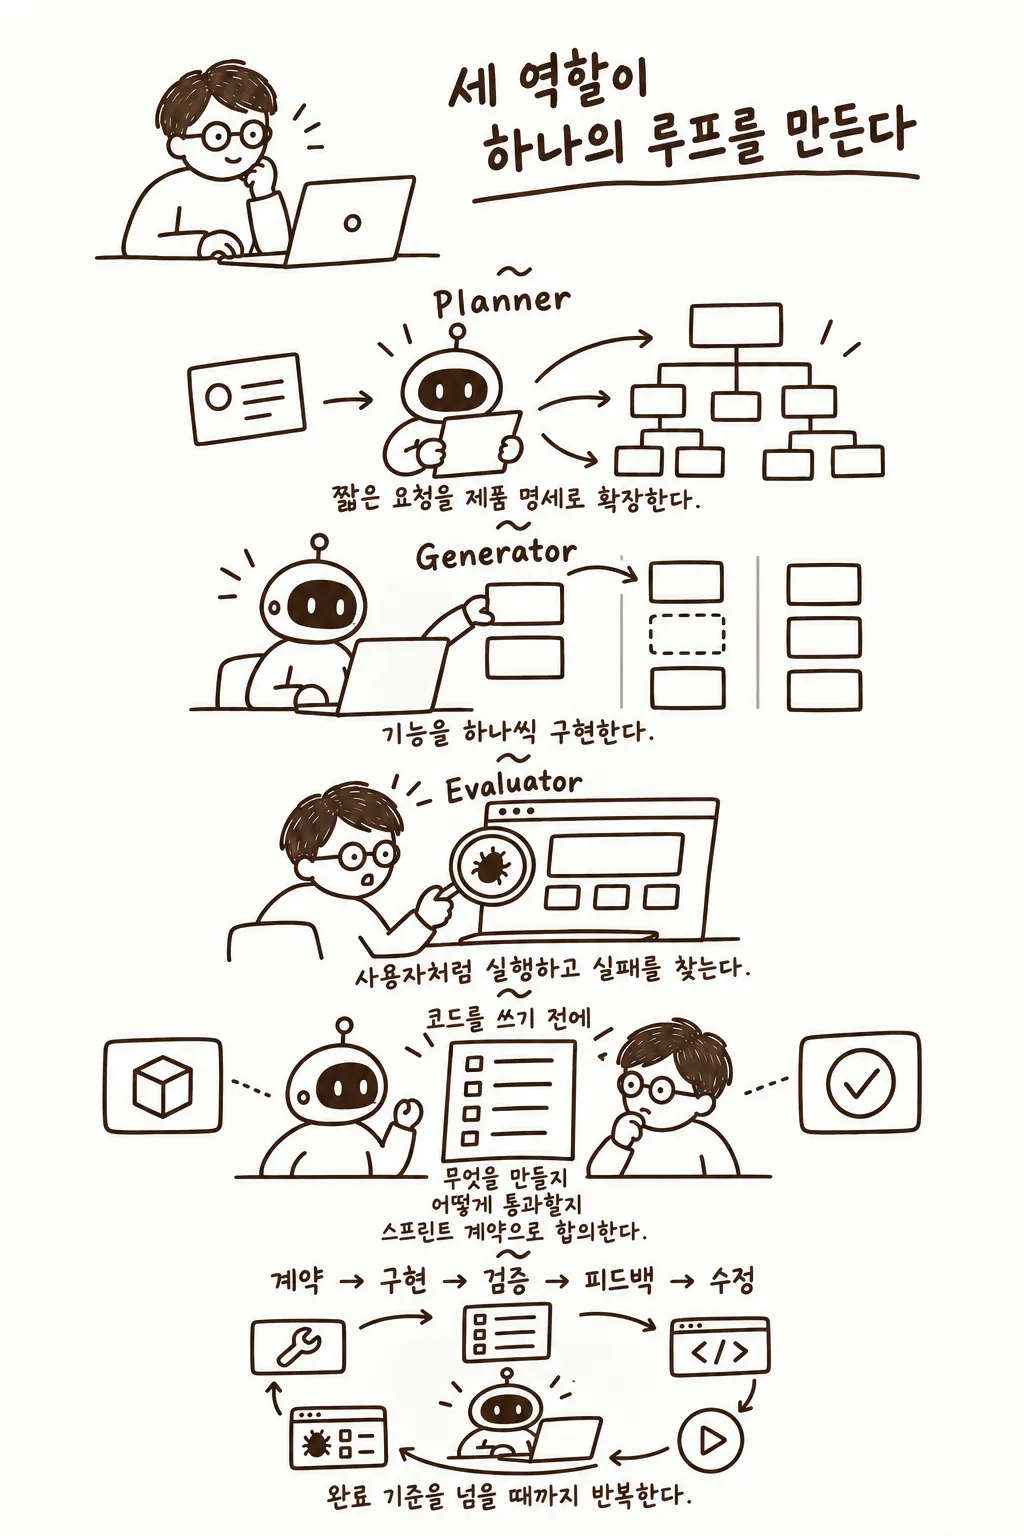
Planner는 한 문장의 요청을 16개 기능, 10개 스프린트의 제품 명세로 확장했습니다. 매 스프린트 전에 Generator와 Evaluator가 구현 범위와 통과 방법을 계약으로 합의했고, 어느 한 평가 기준이라도 하드 임계값에 못 미치면 해당 스프린트는 실패로 처리했습니다.
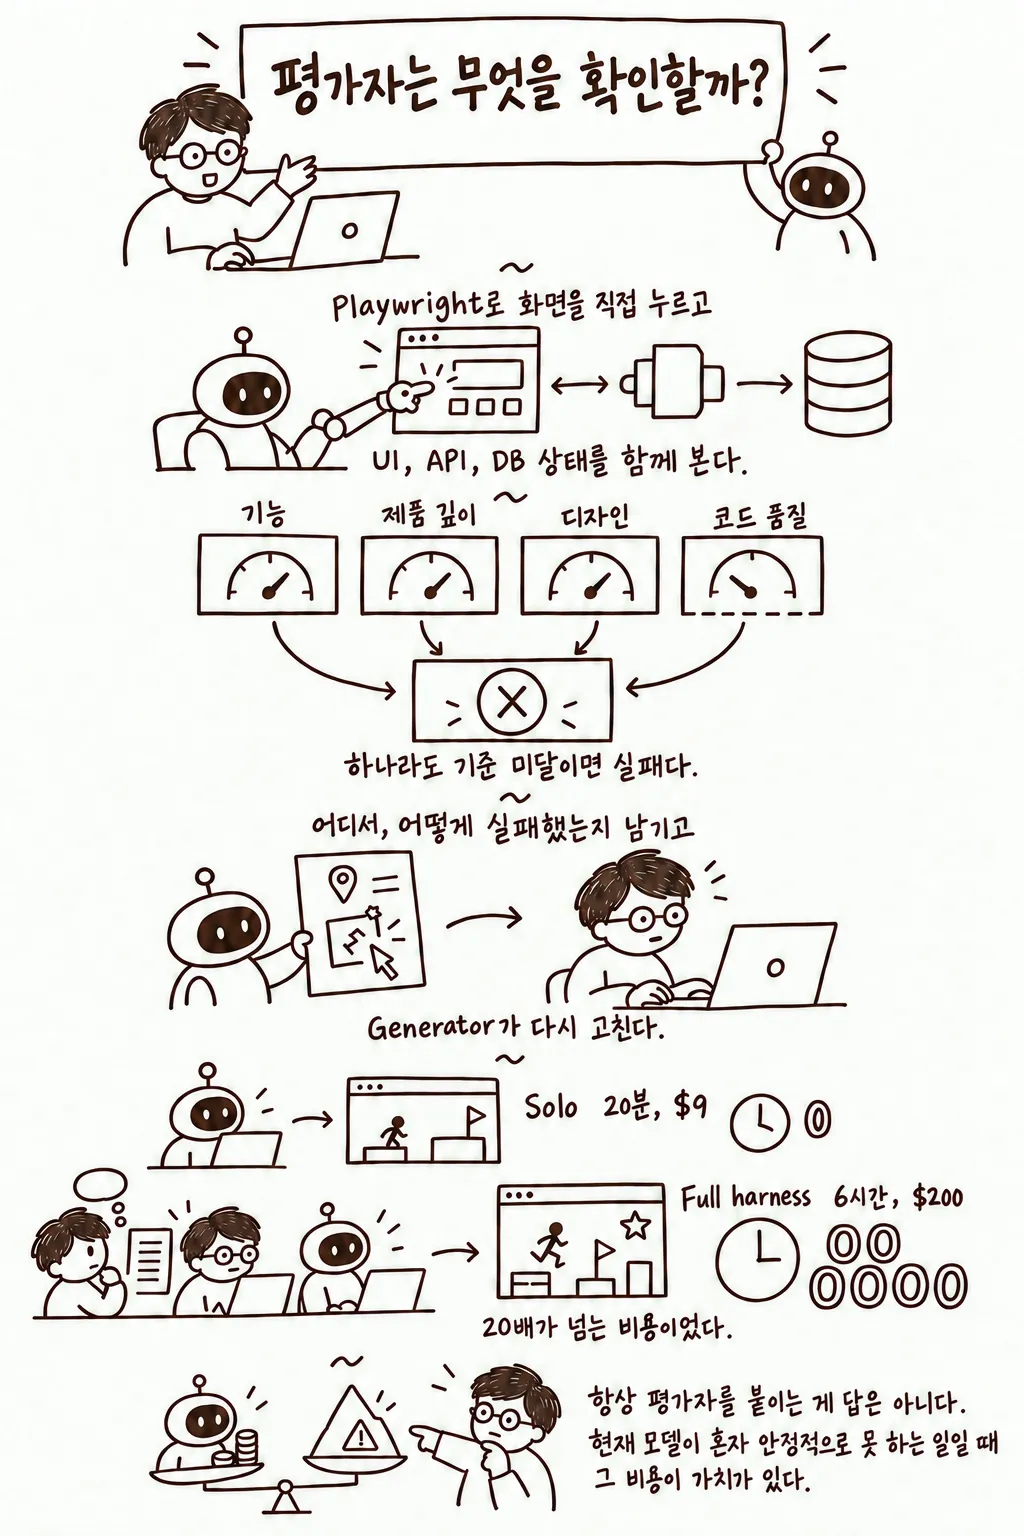
Evaluator는 Playwright로 실행 중인 화면을 직접 조작하고 UI, API, 데이터베이스 상태를 함께 확인했습니다. 단일 에이전트 결과는 겉보기와 달리 핵심 플레이 기능이 작동하지 않았지만, 전체 하네스 결과에서는 캐릭터를 실제로 움직여 게임을 플레이할 수 있었습니다. 다만 비용은 20분, 9달러에서 6시간, 200달러로 커졌으므로 현재 모델이 혼자 안정적으로 완수하기 어려운 일에 선택적으로 적용해야 합니다.